Science刊登中國研究:AI一次看146種病,醫療GPT時刻快來了?
撰文|李珊珊
“一個年輕的放射科醫生最怕進哪個組?”
“那肯定是腹部組。”
浙江大學醫學院附屬第一醫院放射科主任肖文波的一句日常調侃,道出了腹部CT診斷的難度。多個器官擠在同一張影像裏,上百種病變可能同時出現。對放射科醫生而言,腹部CT一直是最考驗閱片經驗的場景之一。
現在,AI開始進入這片“禁區”。
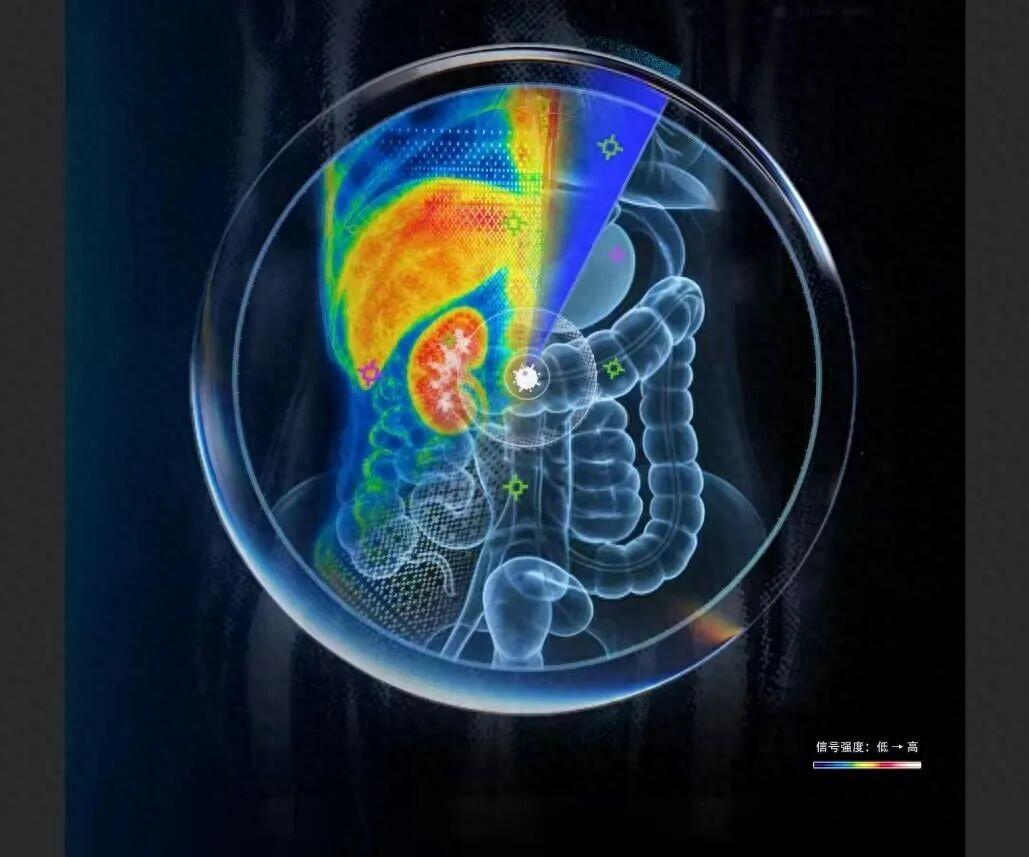
一項9月18日發表於Science的研究顯示:由阿里巴巴達摩院聯合浙江大學醫學院附屬第一醫院等機構研發的通用醫療影像AI模型DAMO RADAR,在面向腹部增強CT診斷中能夠一次性識別超過146種病症,平均AUC達到0.913,首次達到影像科專家水平,並將對外開源。
在一項涵蓋14家醫療機構、26名放射科醫生的人機測試中,除3名資深醫生外,其餘醫生的表現均不及RADAR。而在人機協作診斷中,當一位來自基層醫院、資歷尚淺的年輕醫生,獲得一款新型AI助手的協助後,其診斷敏感度提升了10%。這讓他輕鬆超越了同院的資深前輩,甚至抹平了與頂級三甲醫院主任醫師之間長達幾十年的經驗鴻溝。
事實上,RADAR帶給醫學界的震撼遠不止於此。通過複雜的腹部影像診斷,它開始回答一個更宏大的命題:用於醫療診斷的AI能否不挑器官,不挑病種,不挑場景,從而實現通用?
這個問題的背後,是醫學影像AI一直沒有解決的困境。
從IBM Watson、DeepMind到OpenAI,每一代AI巨頭都要進入醫療。醫療場景對準確率的極致要求,註定是檢驗通用智能能否進入現實世界的終極壓力測試之一。影像是醫學AI率先瞄準的方向,深度學習之父Geoffrey Hinton在2016年就公開預言:“人們現在就應該停止培養放射科醫生。”
但十年過去,影像AI依然進展緩慢,雖然出現了一些精度超過人類醫生的專病模型,但遲遲沒有迎來預言中的AI影像醫生。
核心在於,專病模型的研究範式面臨巨大挑戰:一個疾病訓練一個模型,開發週期漫長、人工標記成本高昂、跨場景泛化能力羸弱。此外,面對分診不那麼明確、器官相互遮掩、合併症頻發的真實就診場景,專病模型的使用場景大受侷限。大家都在期盼一個通用醫療影像AI的GPT時刻。
爲了攻克腹部CT這座高山,達摩院研究團隊選擇一場底層的“自我革命”,突破了原先在專病種模型領域已經得心應手的技術範式,利用分割建模、器官級對齊,並依託遠超同行的數據規模,讓RADAR徹底擺脫對繁瑣人工標註的依賴。
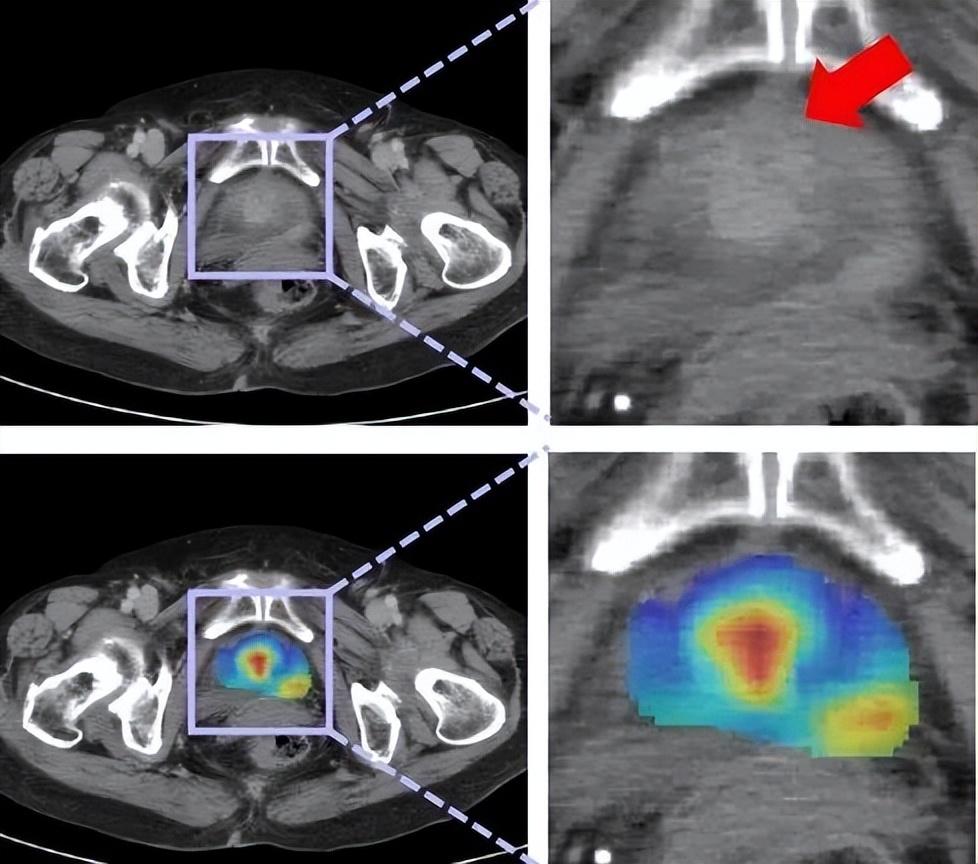
圖源:An expert-level generalist AI for abdominal CT diagnosis,Science
在覆蓋18個器官、146種病症的全面測試中,RADAR完成了從“被動識別單點病竈”到“通用化理解解剖與疾病全貌”的跨越,實現了第一個真正達到專家級水平的通用醫療影像AI模型。
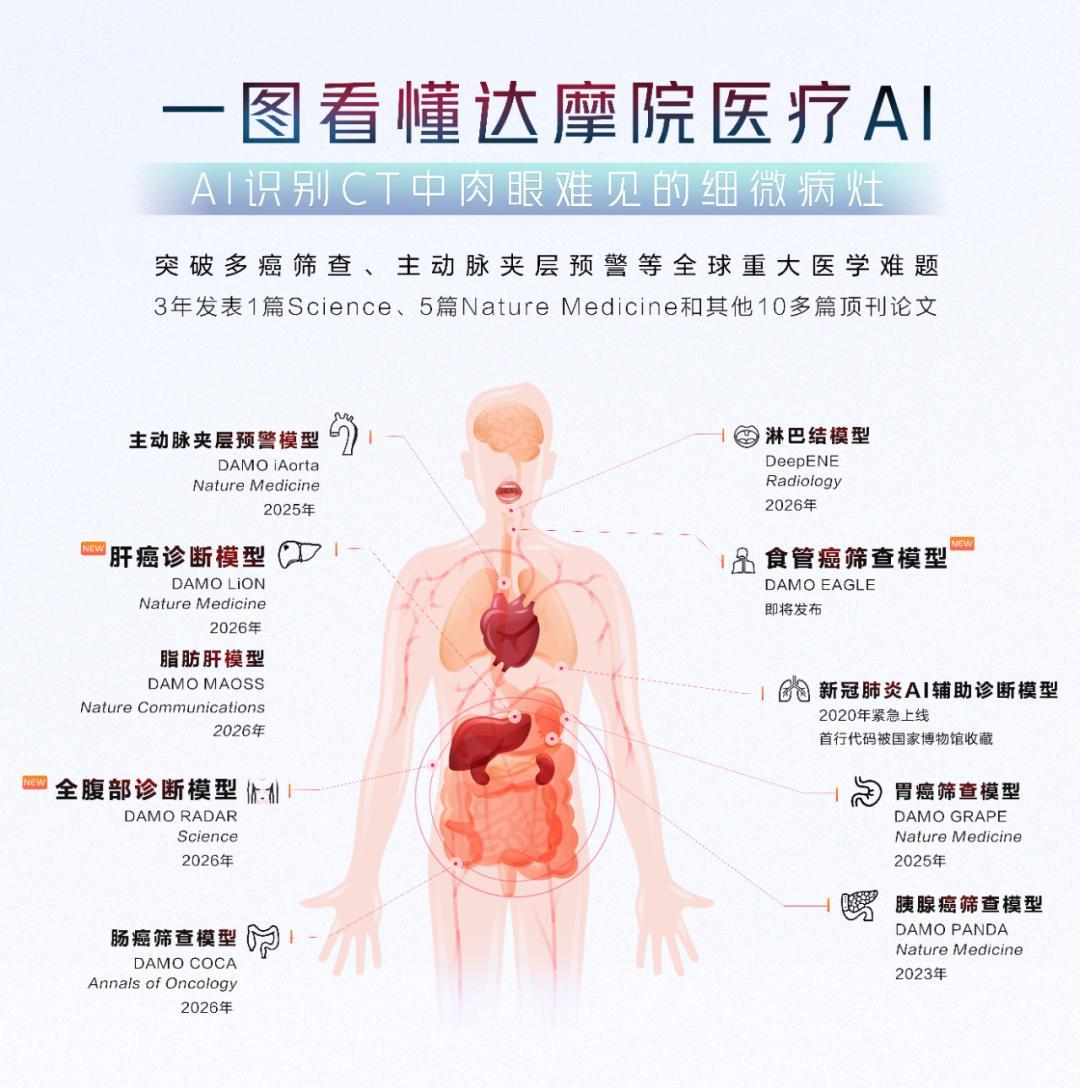
2023年11月,達摩院團隊在《Nature Medicine》雜誌刊發研究論文,通過“平掃CT+AI”的結合,模型可以準確識別早期胰腺癌病變。該雜誌當時配發的評論文章指出,一個醫療影像AI的黃金時代已準備就緒。
如今,又經過三年努力,這個團隊和醫生們迎來了從專病醫療影像AI到通用醫療影像AI的重大跨越。加上模型的開源,這或許會是醫療AGI時代的一縷曙光。
做不完的單病種AI和看不完的CT影像
“按照這個速度,是不是一輩子都做不完?”
這個問題,曾經長時間縈繞在達摩院高級算法專家張建鵬心頭。
在外界看來,過去五年,達摩院團隊在單病種AI上接連突破:從肺癌、胰腺癌(PANDA),到胃癌(GRAPE)、腸癌(COCA),以及最近剛剛發表的關於肝癌(LiON)和食道癌(EAGLE)的工作。數據標註、模型訓練、發論文、出產品,單病種研發路徑已經跑通。
團隊卻始終心有不甘,每結項一個疾病,意味着熬過了幾個月高強度的數據標註與模型訓練。一個病種往往要兩三年,可人類疾病成千上萬;更何況,真實臨牀裏,患者的CT常常同時存在多器官、多種異常的合併症。
“我們開始特別強烈地意識到:如果一直沿着‘一個疾病訓練一個模型’的路線走下去,可能一輩子都是做不完的。”張建鵬告訴《知識分子》,“即使一個項目做成功了,我們解決的也只是很小的一部分問題。”
單病種AI做得越熟練,這種“重複造輪子”的無力感就越強。如果醫學AI永遠是一個個孤立的系統,什麼時候才能真正進入臨牀主流程?
他和同事們反覆追問自己:“有沒有一種可能,AI不是每次只學一個病,而是真正開始學習‘醫學影像本身’?”醫學AI,是不是需要一種完全不同的範式。
距離達摩院不遠的浙大一院放射科,科室主任肖文波這樣形容自己科室:“我們科還蠻大的,300人出頭,70多臺設備。每天可能有七八千的病人流量。”這幾年CT設備越來越普及,輻射劑量降了下來,大衆也越來越重視早診早治,放射科的門診和體檢量漲得很快。僅CT檢查一項,肖文波所在的科室每天就四五千例。
如山的閱片工作量隨之而來。早上,醫生們還能保持清醒、反應敏捷,可報告寫得越多,人也越疲憊。"到下午的時候,可能身心就很疲憊了,腦子反應沒那麼快了。"肖文波坦言。
但這份工作容不得半點差錯。肖文波常告誡科裏的年輕醫生,閱片時要站在患者的角度想:“如果是一個小腫瘤,你漏了,等過半年、過一年,它長得很大了,這個治療方案完全是不一樣的,生存期完全是不一樣的。”
醫生們需要工具來分擔這種壓力,現實卻很骨感。
醫學AI聽起來很熱鬧,比如肺結節領域已經有了不錯的應用,但一旦離開這些單一器官,面對人體最複雜的區域,依然沒有一個好用的AI能幫他們檢出病竈。
這個讓所有年輕影像醫生都感到害怕、沒有任何AI可用、只能靠肉眼在灰暗的屏幕前苦苦排雷的區域,正是腹部CT。
從影像醫生的“噩夢”入手
腹部CT爲什麼這麼難?
肖文波解釋:“它的器官和系統特別多,都堆在一起。”整個腹部盤繞着腸道,裏面有消化系統、肝膽胰脾,還有泌尿系統、生殖系統。
“所有的腹部器官幾乎都是軟組織,大家密度都是差不多的,看起來都是灰灰的。”要在這樣缺乏對比度的畫面裏找病竈,靠肉眼分辨極其細微的密度差異,就像在一片灰色的沙灘上找出灰色的石子。即使打了造影劑做增強CT,只要病竈的密度差不足以在瞬間引起警覺,仍然可能被漏檢;再遇上腹水、解剖結構變異這類複雜情況,畫面會更混亂,病竈也更容易被遮蓋。
“即使一箇中高級水平的醫生,出一份腹部報告,20分鐘到半個小時幾乎是常態。”肖文波說。
這也是爲什麼,儘管在單病領域已經做得風生水起,腹部對大多數醫學影像AI來說依然是一片“禁區”。
達摩院把腹部CT影像作爲了通用醫學影像AI第一站。
“其實最開始提出RADAR這個方向,大家第一反應是覺得這件事太難了,甚至有點想都不敢想,尤其在腹部CT本身就是業內公認非常複雜的場景中。”張建鵬回憶道。腹部CT不像胸片那樣結構相對穩定:器官差異很大,病竈稀疏,不同增強期的變化也很複雜。很多人當時都在懷疑,這樣一種需要同時理解多個器官、上百種疾病,又不依賴大規模人工標註的通才模型,到底有沒有可能真正成立。
早期的探索似乎印證了這種擔憂。當時行業裏探索通用AI的主流做法是簡單的“全圖對齊”,但腹部結構複雜、病竈稀疏,粗放的全局視角很容易讓模型走偏:“模型非常容易走捷徑,關鍵的異常往往會被淹沒掉。”
破局的靈感,來自對臨牀閱片習慣的重新觀察:放射科醫生閱片時本來就是按解剖結構工作的,不會把整個腹部當成一個整體去看,而是依次查看肝臟、胰腺、膽道、腎臟、腸道,再綜合不同器官的信息作出判斷。
團隊開始設想:能不能讓AI也按照這種方式學習。張建鵬解釋,醫學影像AI或許不能簡單照搬自然圖像的範式,而需要一套更符合臨牀認知的結構化學習框架:把CT拆解成器官級別的視覺單元,同時把診斷報告拆解爲對應的解剖學描述,再進行細粒度對齊。用他的話說,這相當於把原本“一句很長、很模糊”的圖文對應關係,變成了更明確、更局部的對應關係。
在張建鵬看來,這一步轉變最重要的意義,是讓模型真正建立起“解剖結構—影像表現—語言描述”之間的聯繫,而不只是性能上的提升。
“醫生雖然沒有再做標註,但也做了非常龐大和艱辛的工作。“達摩院資深算法專家張靈介紹,浙大一院爲這項研究建立了一個全球性的醫院協作網絡,做了大量實驗設計和驗證工作,持續推動模型的優化。在他看來,正是算法專家的技術創新和醫生們的銳意進取,共同構建起了RADAR這套體系。
這樣訓練出來的模型,究竟是真正學會了醫學影像,還是隻是在另一種方式上重複“一個病種一個模型”的老路?
答案最終要走出訓練集進入下個環節。
不只是“看得準”:AI開始挑戰人類醫生了
RADAR需要回答的第一個基本問題是:面對複雜的腹部CT,它到底能不能看得準?
答案是肯定的。
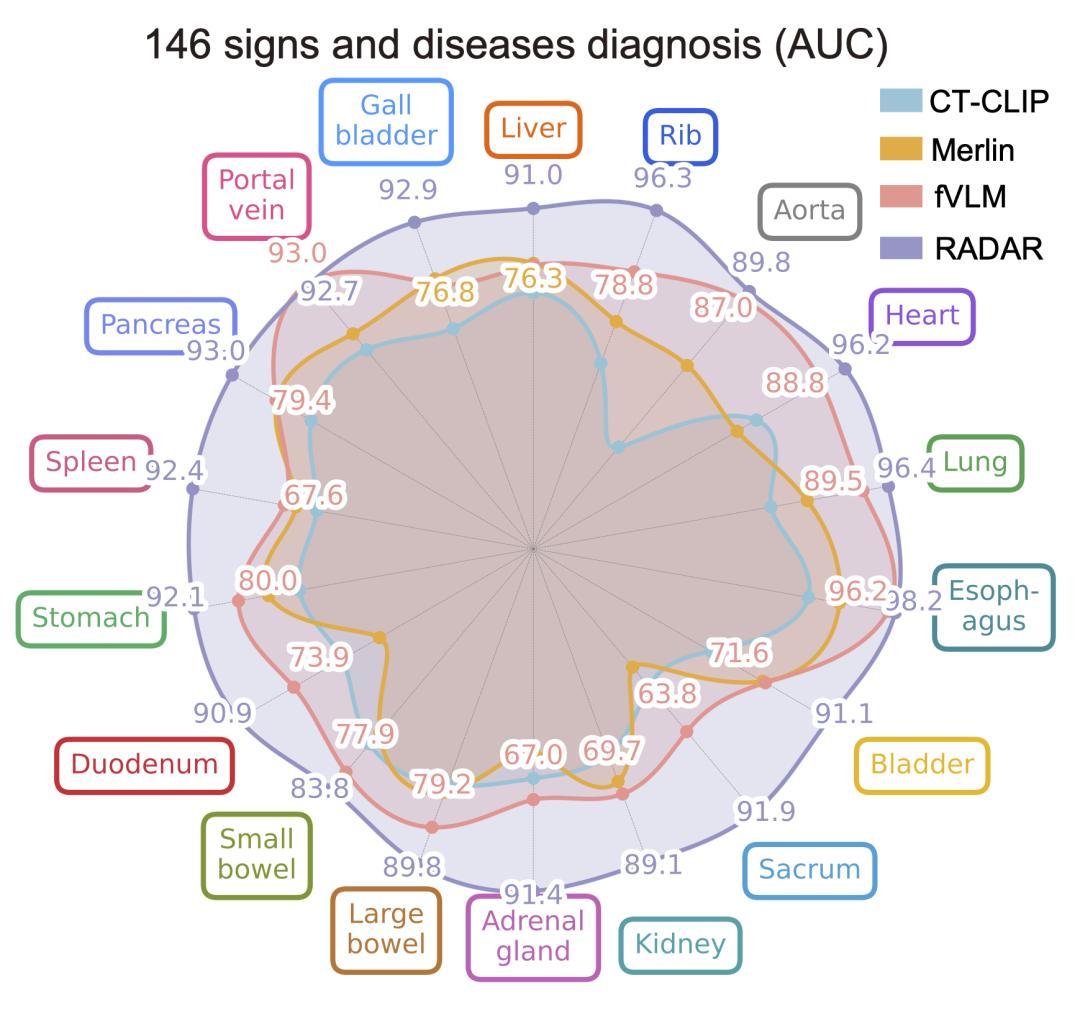
RADAR在146種病症診斷上的表現
在覆蓋腹部18種器官、146種病症的測試中,RADAR的平均AUC達到0.913。這個結果,曾令肖文波直呼“不敢相信”。AUC(曲線下面積)是醫學上評價診斷模型的重要指標,1分代表能夠完美區分陽性和陰性病例,0.5意味着接近隨機判斷,超過0.9通常被認爲具有很高的診斷效能——這是一個幾乎比肩人類影像醫生水平的診斷。
但對於一個真正的通用模型來說,“看得準”還只是第一關。
如果它只能在訓練過的疾病上表現良好,那麼本質上仍然只是把過去的“一個疾病一個模型”做得更大一些。真正困難的問題是:當面對沒有專門訓練過的疾病、病例和臨牀場景時,它還能不能工作?
這也是RADAR與傳統醫療影像AI最重要的區別之一。
過去的醫療影像AI,通常圍繞一個明確任務開發。比如識別肺結節,就收集大量肺結節CT進行標註和訓練;如果要識別胰腺癌,就再建立一套針對胰腺癌的數據集和模型。
這種模式當然可以把一個具體問題做得很好,但它有一個天然的限制:臨牀需要按照AI的訓練集給患者做完美的分診,而這幾乎是不可能的。真實世界裏的CT檢查,往往同時面對不同疾病、不同器官和不同程度的異常。尤其在急診科,醫生甚至很難預先知道自己下一張CT會遇到什麼。
爲此,研究團隊把RADAR帶到了一個它在訓練集中從未見過的場景:急診。
急診的特殊之處在於,醫生不僅要“看得準”,還要“反應快”。面對大量同時到來的患者,哪些人病情危急、需要優先檢查和干預,往往需要儘快作出判斷。對於醫療AI來說,這恰恰是一個很有潛力的應用場景。
張建鵬認爲,按照目前RADAR展現出的初步判斷能力,它有希望在急診中承擔一種“及時預警”的角色:快速從一批患者中識別出可能存在緊急情況、需要優先處理的人羣,幫助醫生完成初步分診。
然而,急診也並不是簡單地換了一批病例。醫生面對的不是一個預先定義好的疾病篩查任務,而是一個開放的問題:這個患者到底出了什麼問題?
今天送來的是腹痛,究竟是闌尾炎、腸梗阻、消化道穿孔,還是其他疾病?CT裏可能同時存在多個異常。醫生需要先從複雜的影像中找到值得注意的徵象,再進一步判斷這些徵象意味着什麼。而這恰恰是過去單病種AI最難覆蓋的地方。
在一項包含27,267例急診CT的測試中,RADAR面對17種常見急腹症,平均AUC仍達到0.904。
也就是說,研究人員沒有專門教它“急診應該怎麼看”,它仍能把此前學習到的影像規律遷移到新的臨牀場景中。對於“通用”模型而言,這個結果比某一種疾病上的高準確率更有意義。
如果說急診考驗的是RADAR面對陌生場景的能力,那麼另一項實驗回答的是一個更直接的問題:它能不能真正幫助醫生?
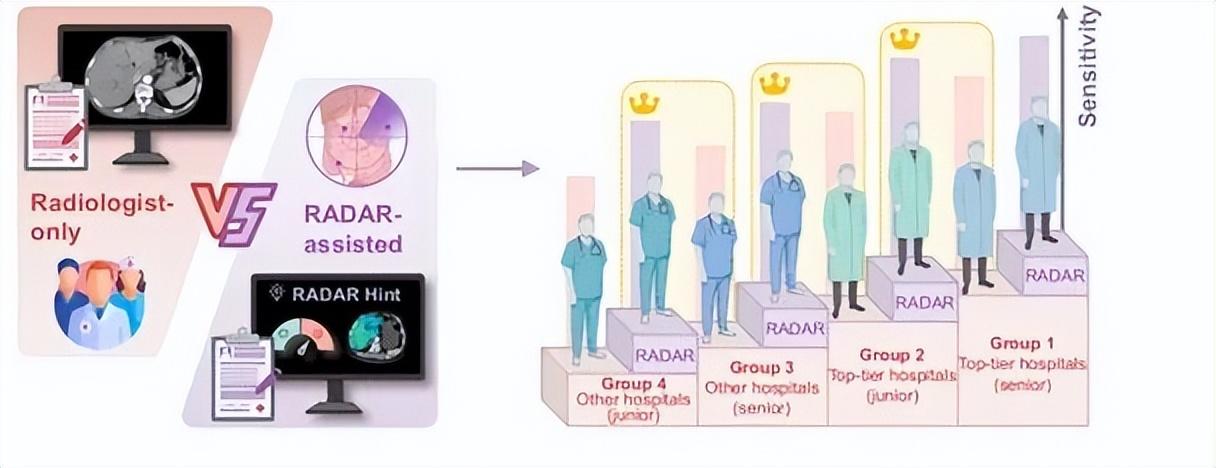
人機測試顯示,由RADAR輔助的年輕醫生,表現優於資深醫生。
研究團隊讓來自14家醫療機構的26名放射科醫生——11名資深醫生和15名初級醫生——在不知道患者主訴和病史的情況下,獨立閱讀300例腹部CT。結果,只有3名資深醫生的表現略好於AI,其餘醫生均不及RADAR。
一個月洗脫期後,同一批醫生再次閱讀這些病例。這一次,RADAR會提供輔助:給出初步判斷,並用熱力圖標出可能異常的區域。
結果很明顯。AI輔助後,醫生髮現病竈的靈敏度整體提高10.0%,平均閱片時間縮短30.7%。
在一些更棘手的場景中,檢出靈敏度也有相當幅度的提升:惡性腫瘤提高7.3%,急診場景提高8.5%,空腔器官疾病——如胃腸道、膽囊的穿孔或梗阻——提高9.4%。
更值得注意的是年輕醫生的變化。
在頭部醫院,初級醫生獲得RADAR輔助後,診斷水平追平了不使用AI的資深專家,靈敏度甚至高出3.4%。在其他層級醫院,初級醫生藉助AI後的綜合表現則超過了同院資深醫生7.0%。
在AI輔助下,剛入行的年輕醫生,也能給出資深專家水平的準確判斷。而在傳統放射科,一名醫生要獨當一面,往往要熬過十幾年、看過成千上萬張片子,還得跟在資深醫生身邊慢慢積累經驗。
視頻解讀: Science研究,一個專家級的通才醫療AI
醫療影像的GPT時刻和未竟之局
對醫療AI行業來說,RADAR的意義不只在於腹部CT上的數據表現。這項研究發表於《Science》後,不少討論提到,這是否會是AI醫療影像領域的“GPT時刻”。
對於這個說法,張靈的態度謹慎:"在腹部CT影像多病診斷領域,我們也許有點像是GPT-3的時刻,還沒有到真正的腹部CT影像的ChatGPT時刻,但已經是在前夕了。"
張建鵬則認爲:“‘GPT時刻’的說法,應該更多想表達的是範式變化。”具體來說,是底層任務能力從“一”到“多”的轉變:GPT用一個模型處理多種任務,醫療AI也正從單病種模型走向“通才”模型。
過去,標註成本高、單病種模型又相對封閉,醫療AI發展一直較慢;面對數據稀缺的罕見病,傳統監督學習的效果也常常不理想。RADAR提供了另一條路徑:基於視覺-語言(Vision-Language)的通用模型框架,可以直接從大量未標註的真實臨牀報告中學習,而器官級對齊的算法創新讓通用方法終於能在醫療影像上一展所長。
“它的訓練範式是可擴展的(scalable)。”張建鵬說,這一點與GPT的自監督學習類似:“臨牀系統裏天然存在的報告就相當於醫療場景裏的互聯網語料。藉助這些信息,我們不需要做人工標註,標註代價非常低。”這讓團隊繞開了“一個病種一個模型”的老路。
目前,Scaling Law似乎還沒有見頂。“我們做了不同數據比例的實驗,發現從Scaling Law曲線來看,性能還沒有飽和。”張建鵬告訴《知識分子》。 “隨着後續更多數據、更多模態的加入,模型潛力還會更大,有非常多的提升空間。”
研究團隊還觀察到了類似GPT的“能力湧現”:模型在複雜急診場景和跨人羣分佈中,都展現出良好的穩定性與零樣本泛化能力。語言驅動的學習方式,也讓RADAR不再侷限於簡單的“有病/沒病”二元判斷,而能捕捉病竈的位置、形態、紋理等更多屬性。
不過,張靈也談到,RADAR要真正成爲臨牀裏的“ChatGPT”級產品,還需要跨過工作流嵌入、可解釋性、監管審批等一系列門檻。
當然,在張建鵬的眼中:未來的AI影像醫生不僅存在於放射科,“它可能會變成整個醫療系統裏的基礎智能能力。比如在急診,AI會提前識別急腹症和高危患者;在體檢中心,AI會做大規模早篩;在MDT討論裏,它還能自動整合歷史影像和病程變化;在基層醫院,它會幫助年輕醫生獲得接近高水平醫院的影像能力。”
按照這一圖景,相比於探索醫學影像的未知領域,RADAR這類通用大模型眼下更現實的意義,正是打破不同層級醫療機構之間的經驗壁壘,讓優質醫療資源以更低成本複製。
在影像學界,“同病異影、異病同影”是常見的臨牀難題。浙大一院肖文波坦言,即便是三甲醫院的主任醫師,也不可能閱盡幾十萬張片子裏的所有罕見與常見腫瘤特徵。良惡性腫瘤的鑑別往往只在毫釐之間,卻直接決定患者是隻需隨訪,還是必須接受治療。
“當我對一個病竈猶豫的時候,臨牀信息已經幫助不到我了。此時AI能給我一個支持,就像我再找一個專家來告訴我,你覺得像什麼?”肖文波說,AI能給醫生更多診斷信心。
對基層醫院來說,這一點更加重要。閱片量和經驗有限,面對複雜的腹部CT時,誤診漏診的風險更高,AI可以補上這塊短板。
肖文波回憶,跟同行交流這項成果時,不少基層醫生的第一反應就是“能不能給我們裝一個”。現實中,漏掉一個微小腫瘤,半年後的治療方案和患者生存期可能完全不同。AI的介入,至少能幫基層醫院減少這類遺憾。
但AI能力提升的同時,另一個問題也逐漸浮現:高度自動化的工具,會不會讓年輕醫生失去重要的邏輯分析能力?
“影像診斷需要一整個的影像邏輯思維。”肖文波在臨牀帶教中注意到,一旦引入AI輔助軟件,年輕醫生的報告水平能迅速接近主任醫師;可一旦拿掉AI,實際水平馬上就會顯現出來。“大家都有惰性,AI馬上查出病竈並給出診斷,慢慢就忽略了從年輕醫生到成熟醫生的培養過程。”
但在肖文波看來,這不是AI本身的問題,而是用法的問題——同樣的工具,用來替代思考,會讓年輕醫生變懶;用來倒逼思考,反而能加速成長。
過去,影像科的傳承靠的是老醫生手把手批改手寫報告,但如今大三甲醫院科室動輒數百人、工作量飽和,這種“師徒制”已經很難維持。
基於這樣的情況,她設想了一種新的帶教方式:年輕醫生先按照常規獨立寫報告,完成後再用AI軟件自查,“就像有個醫生站在旁邊提醒,‘哎,你看這還有一個病竈,你怎麼沒看見?’”
這樣一來,AI不是替年輕醫生下判斷,而是等他們自己先判斷過一遍,再給出對照和糾錯。每一次自查,都變成了一次具體的學習機會。
AI會不會改變醫學影像的傳承方式,現在還很難說。但至少眼下,它已經在幫一部分醫生——無論資深還是年輕——把更多注意力,留給那些真正需要猶豫的病竈。
參考資料:
1. Qi Zhang et al. ,An expert-level generalist AI for abdominal CT diagnosis.Science393,eaec6129(2026).DOI:10.1126/science.aec6129