一個真正能做科研的 AI,應該長什麼樣?
撰文|張天祁
AI已經能夠寫代碼、證明數學定理,爲什麼它還沒有真正成爲一名科學家?
這是AI for Science 面臨的一個困難的問題。
在棋類中,AI 可以通過明確的勝負規則不斷自我博弈。在數學中,一個證明是否成立,也可以藉助形式化驗證工具快速判斷,這都加速了AI在相應能力上的進化。但科學研究很少有這樣清晰的對與錯。一個實驗結果可能需要反覆驗證,一個假說可能存在多種解釋,一個研究方向是否值得繼續,也很難由一條確定的規則給出答案。
“科學發現其實是一個非常長程的任務。”PhAI Labs 聯合創始人、普林斯頓大學博士後楊靈告訴《知識分子》。
面對複雜的科學發現任務,單靠現成的智能體、工具調用或者預先寫好的工作流,很難讓AI 長時間穩定地完成研究。因爲科學研究並不是把一個任務拆成幾個步驟之後依次執行就可以了,它需要在一次次結果和反饋中調整自己的工作方式。
問題在於,AI不僅要完成每一步,還需要判斷如何進行下一步行動,而科學恰恰缺少數學和編程中那樣明確、快速的驗證機制。如何建立這樣的反饋和驗證閉環,成爲AI for Science加速的關鍵。
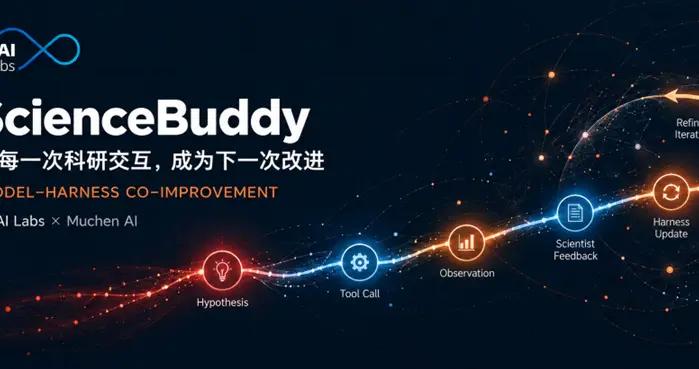
9月16日,PhAI Labs發佈ScienceBuddy,沐晨科技(Muchen AI)作爲聯合研發與技術支持方參與推進。這是一個面向科學家研究工作空間,也旨在探索如何讓科學Agent在真實科研交互中持續改進。
PhAI Labs(官網 phai-labs.com)是一家面向開放式科學發現的新型研究組織,團隊成員具有斯坦福、牛津、普林斯頓等高校及產業機構的研究經歷。
科學家的AI搭檔,可以越用越聰明嗎?
從提出假設、分析數據到設計實驗,AI 智能體正在切入科研最核心的腹地。
爲了弄清一類超級細菌如何跨物種傳播抗生素耐藥性,英國帝國理工學院微生物學家何塞·佩納德斯(José Penadés)團隊耗費了近十年時間。
兩年前,帶着幾分好奇,佩納德斯把這個難題輸入給谷歌 DeepMind 的 AI 智能體 Co-Scientist。
僅過了兩天,系統就交出五種假說。排在第一位的,正是佩納德斯花了近十年才證實的機制。他被震懾住了,如果過去有這項工具,團隊本省下數年時間。
DeepMind 將AI 智能體的帶來科研突破歸結爲三點:更強的前沿基座模型、激發模型潛力的“腳手架”(Scaffolding)機制,以及允許科學家量身定製的能力。
不過,在定製性這個方面,AI還遠遠不夠徹底。科學家哪怕對腳手架裏的提示詞修修補補、寫幾套特定skill,AI 也只是根據這單次反饋重跑一遍,當下好用了,可換到下一個新問題,依然得從頭手把手再教一遍,像個健忘的學徒。
這種情況下,AI 與科學家的合作容易變成一個個孤立的任務,而不是一個能夠隨着研究不斷積累經驗的循環。科學家疲於重複下令,AI 也無法從長期的合作中真正吸收科學家的思考與品味。
PhAI Labs帶來的ScienceBuddy,試圖改變的正是這件事。它希望成爲的,不只是一個幫科學家完成任務的工具,而是逐步進入真實的科學研究過程,成爲一個能夠越用越聰明的項目夥伴。
“就像它的名字一樣,成爲科學家的項目夥伴(Buddy)。”PhAI Labs 聯合創始人、斯坦福大學AI4S博士後吳英成說。
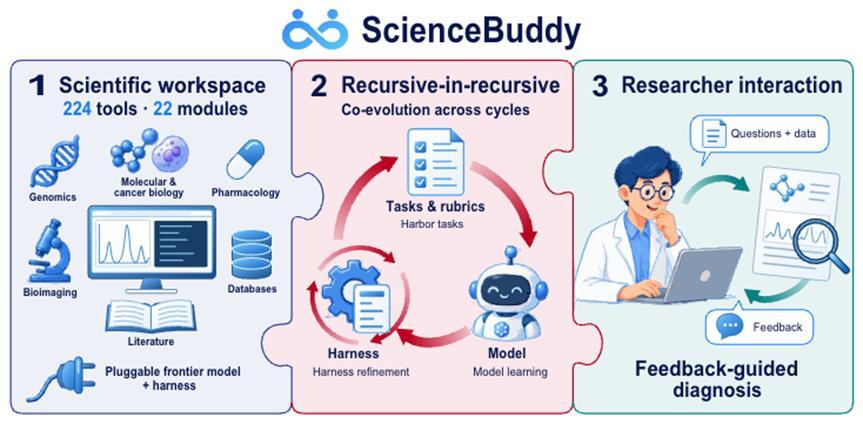
ScienceBuddy的整體構成。 它將科學工具與工作空間、Recursive-in-Recursive 自我改進機制以及研究者交互連接在同一個系統中。研究者提出任務並提供反饋,系統將交互轉化爲任務、評估標準和診斷證據,再將改進後的模型與 harness 帶回下一輪科研協作。
現在,很多AI 智能體已經可以完成文獻檢索、數據處理和工具調用,但是,這些工具之間往往彼此割裂,研究人員仍然需要自己把數據、代碼、工具和分析過程組合起來。
ScienceBuddy首先試圖解決的就是這個問題。它不僅是工具,更是科學集成開發與運行的環境(ScienceIDE)。它的22 個功能模塊中集成了 224 種專業工具,覆蓋基因組學、藥理學、生物成像、文獻檢索及數據庫查詢等多個領域。面對具體問題時,研究人員可以在提出問題、處理數據和調用科學計算工具之間無縫切換。
此外,PhAI Labs將 500 多個科學計算工具適配到 GPU 環境。吳英成舉例,分析千萬級細胞的單細胞轉錄組數據,在傳統 CPU 上通常需要運行數天,而在 GPU 並行加速下,這個時間被壓縮到 30 秒左右。
當然,對科學家來說,更重要的不只是便捷和效率,而是模型能否在持續反饋和外部證據中,真正理解和學會做研究。
ScienceBuddy有什麼不一樣?
對於一個真實的科研項目來說,研究人員很少在一開始就知道最後要得到什麼答案。更多時候是先完成一輪分析,再根據結果確定下一步研究什麼。一個異常結果要不要繼續追問?幾個可能的機制,先驗證哪一個?實驗做完之後,下一步該換條件,還是換問題?
這些抉擇離不開科學家的經驗與品味。在此過程中,如果只能靠科學家手把手的指導,AI智能體就稱不上一個科研上的夥伴。
ScienceBuddy真正進入的,正是這段不斷分岔和循環的路程。
JAK1 與小細胞肺癌免疫治療的研究就是一個例子。研究人員把臨牀數據和單細胞數據交給 ScienceBuddy,先研究 JAK1 與免疫治療療效、免疫細胞和免疫特徵之間的關係。第一輪分析完成後,問題繼續往下走:JAK1 的上下游調控是什麼?細胞之間是否存在相應的通訊關係?研究人員根據前一輪結果繼續提出任務,ScienceBuddy再回到數據和工具中,完成下一輪檢索、分析和計算。
一個項目就這樣被拆成一連串相互銜接的任務。真正有價值的不只是某次分析得出了什麼結果,而是研究人員拿到結果之後做了什麼。是接受答案,修改問題,換一個方向,還是繼續追蹤?
楊靈把這種反饋稱爲“隱式標籤”,研究人員不需要額外告訴系統哪個答案是100分,真實科研中的這些選擇本身就是反饋。
這也是ScienceBuddy與其他AI工具思路的差別。並不是任務結束,下一次仍然從頭開始,而是多輪交互,不斷帶着科學家的經驗和判斷返回科學現場。這些判斷積累起來,AI學到的就不只是一個研究領域裏的知識,還包括一個科學家做研究的品味。
“隨着交互越來越多,ScienceBuddy能夠更好地把握你當前的科研場景,以及個人的科研品味,這樣就能做到更個性化”。楊靈說。
PhAI Labs把這個過程稱爲嵌套式遞歸自我改進(Recursive in Recursive,雙層RSI)。外層RSI首先改進的是完成科研任務的Harness,也就是提示詞、任務調度、工具調用和科研環境組成的工作流。一次任務結束後,系統根據反饋調整工作流,下一次遇到類似任務時,可以採用更合適的執行方式。
再往裏一層,是基座模型本身的改進。楊靈介紹,如果只是調用模型接口,可以先通過本地RSI自動調整任務執行方式。如果有本地GPU資源,還可以進一步訓練本地模型。
這種對品味的學習並不只是一種模仿。隨着反饋不斷積累,AI不只是越來越懂這個科學家,也會越來越聰明,改變自己完成真實科學任務的能力。
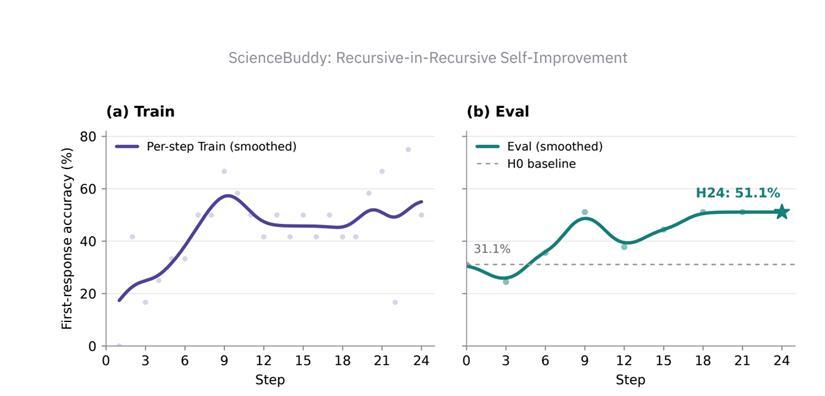
在生物醫學科研的評測中,ScienceBuddy已經有了不錯的表現勢頭。在底座模型參數完全凍結、只持續優化工作流(Harness)的情況下,45 個長程科研任務的首答準確率從 31.1% 提升到 51.1%。另一組實驗則固定最初的Harness,把積累下來的任務細則轉化爲強化學習信號,用來訓練模型本身,180 個科研問題允許模型最多嘗試4次,問題解決覆蓋率從48.3%提升到了67.8%。
AI已經會做數學,爲什麼還不會做科學?
近期,AI攻克頂級數學難題的消息不斷出現,也引起了數學界的強烈反響。相比之下,在科學領域,儘管AlphaFold已經獲得諾貝爾獎,人們仍然很難舉出一個像數學證明那樣得到普遍認可、由AI獨立推動完成的重大科學發現。
2026年7月,谷歌DeepMind發佈一篇題爲“猜想機器”(Conjecture Machines)的文章,直接把問題指向科學發現中的驗證瓶頸。文章的核心觀點是,AI智能體讓科學假設和候選方案的產生變得又快又便宜,但檢驗這些想法能不能在現實世界站住腳,依然要依賴實驗室、設備和制度性的審查流程,這部分工作又慢又貴,短期內很難加速。數學和編程之所以例外,是因爲它們完全可以通過計算機來驗證。
這背後其實是過去幾年AI能力躍遷的共同邏輯。AI能力的增長不僅來自模型本身,也來自一個足夠快的反饋閉環。驗證越快,模型就越有機會在更短時間裏嘗試更多次。
楊靈提到,數學的驗證之所以能夠支撐更快的發展,很大程度上正是因爲它的確定性。數學沒有不置可否這一說,對就是對,錯就是錯,而且有相應的形式化驗證。
如果想把這種能力擴展到科學和工程,問題就變成了:在真實的科研過程中,什麼能夠充當科學發現的驗證標準?
吳英成此前從事生物醫學研究,後來研究方向轉向 AI for Science,他想和同事們推進科學發現整體的速度。“說得宏大一點,我們希望改變人類知識增長的速度,讓知識空間的延展速率顯著提升”。
在科學研究中,一個假設從提出到實驗驗證,往往需要幾周、幾個月、幾年甚至更久。這意味着,即使AI幾分鐘提出大量假說,人類仍可能需要很長時間才能驗證哪些值得繼續。
與數學不同,科學上的很多東西不是一個零一值,它需要做很多種驗證,有時候甚至同一個問題,比較資深的科學家和其他科學家得出的意見也不一致。到底聽誰的,並沒有一個固定答案。不同的人、不同的驗證方式,最後得到的結果也可能不同。
“這是AI for Science領域非常難的一個問題,怎麼樣在一堆不確定性當中找到確定性的驗證方式,並且完成科學自動化驗證的過程。這是AI for Science加速的關鍵”。楊靈說。
楊靈把問題分爲幹實驗和溼實驗兩個部分。
幹實驗首先是一個長程任務。它不是完成一次分析就結束,而是要從文獻調研開始,經過數據分析、實驗規劃,再根據每一步得到的結果決定下一步怎麼做。對於一個具體問題,AI可能需要連續完成50步、100步甚至1000步,任何一個環節出現問題,都可能影響後面的判斷。相比於針對一個確定問題給出答案,這種不斷根據結果調整下一步行動的能力,對現有AI來說要困難得多。
目前很多AI for Science系統會把一套相對固定的幹實驗流程嵌進去,讓模型在限定的任務和工具中完成分析。但如果希望AI能夠進入更廣泛的科學研究,就不能只依賴預先設定好的流程,而需要它面對不同的科學問題、不同的數據和不同的研究環境,自己組織後續的研究步驟。
這也是ScienceBuddy一開始從科研數據入手的原因。楊靈認爲,他們需要積累足夠多的長程科研過程,讓模型逐漸學會不同科學領域中這些反覆出現的研究模式。
楊靈認爲,這類反饋中尤其重要的,是從一個結果到下一步行動之間的轉換:得到一份分析結果之後,下一步該繼續追蹤、改變分析方法,還是轉向另一個問題。相比於針對確定問題給出答案,這種根據當前結果規劃下一步行動的能力,是現有模型相對欠缺的。這也正是ScienceBuddy想從和科學家的協作中學習的。
但最終要形成科學發現的閉環,僅僅處理幹實驗還不夠。
吳英成把自己正在做的事壓縮成一句話:上一代AI蒸餾的是互聯網,下一代AI for Science應該“蒸餾地球”。互聯網教模型描述世界,科學實驗教模型干預世界。
在他看來,互聯網是一個存量,是人類已經寫下來的東西的總和,再大也有邊界;地球則是一個增量,自然每時每刻都在生成新的、還沒有被任何文本記錄下來的答案。要拿到這些答案,AI不能只在電腦裏提出假說,還要進入實驗室,完成實驗、拿回結果,再繼續迭代。“下一代AI for Science比較的,是誰能找到通向自然的API。對我們來說,這個接口就是溼實驗。”吳英成說。
幹實驗可以通過數據、模型和模擬器(Simulator)不斷獲得反饋,溼實驗則需要物理世界的反饋。這也是吳英成爲什麼更看重“具身的自主實驗室”,而不基於固定工作站和規則的自動化實驗室。
在吳英成看來,兩者的本質區別在於,自主實驗室建立在世界模型(world model)和世界行動模型(world action model)之上。它可以由輪式雙臂機器人、類人型機器人等具身系統組成,適應不同的科研場景、儀器和實驗室環境,而不是隻能在預先設定好的工作站中執行固定流程。
“自主實驗室能夠理解當前的實驗狀態,能夠理解實驗結果爲什麼會成功、爲什麼會失敗,更重要的是,它能夠進行主動探索,並且是一種可以持續學習的基礎設施,是一種能持續獲得高質量科學經驗的方式”。吳英成說。
在這樣的科學環境裏,實驗本身就成爲一種驗證。例如,細胞是不是癌細胞,加入藥物之後癌細胞的生長速度如何變化,都可以成爲對AI假設的反饋。
吳英成透露,這套機制已經在他們名爲 GALILEO 的自主發現系統中落地。他們已經在這一場景下做了兩個應用,針對的都是過去被稱爲“不可成藥”的癌症靶點,一個是離子通道,另一個是多次跨膜蛋白。
這兩類蛋白過去之所以被認爲難以成藥,是因爲蛋白結構足夠複雜,可被設計的表位又足夠窄、足夠小。過去無論使用傳統方法設計抗體,還是使用擴散模型,都很難設計出真正具有成藥潛力的高親和力靶點。
基於自主實驗室、具身科學場景和RSI的方法,經過多輪迭代,他們目前已經設計出了納米級別的多肽。
吳英成認爲,這正體現了用於科學發現的基座模型(Discovery Foundation Model)的潛力。“我們現在相信的是,我們能有一套面向科學發現的基座模型,能夠把驗證的週期從幾周、幾個月,壓縮到以秒或以分鐘爲單位。這是我們現在非常感興趣的方向。”這也是他所說的“蒸餾地球”最終要做的事:把假說、行動、實驗反饋和失敗軌跡,轉化爲模型能夠學習、評測和驗證的科學經驗。
目前這套溼實驗體系還沒有與ScienceBuddy直接集成。不過,吳英成說,最終希望能夠把兩者打通,直接連接這樣的具身科學環境,最終讓ScienceBuddy像調用科學計算的MCP工具一樣,直接調用真實實驗能力。
兩者打通之後,溼實驗得到的結果還需要重新進入幹實驗,成爲下一輪規劃、修改猜想或調整實驗方案的依據。楊靈認爲,真正的閉環就在於這個過程能夠持續運轉:從數據中發現新的模式,提出和推進假設,再通過溼實驗獲得真實世界的反饋,並據此決定下一步做什麼。“怎麼樣真正把這套系統跑起來,做到每一輪迭代都有新的發現、新的進步,我覺得這是另外一個很重要的部分。”
從解決問題,到提出科學問題,AI需要更多科學家的幫助
今天,AI 已經學會了回答問題。那麼,AI什麼時候可以學會提出科學問題,學會“發現”?
提問並不是一種單一能力,它是建立在對科學的理解之上。什麼現象值得追問,哪裏存在值得研究的空白,一個模糊的觀察怎樣變成可以驗證的問題,甚至應該先看什麼、排除什麼,這些判斷都很難直接從論文的最終結論中學到。
谷歌的AI co-scientist已經做出了一些嘗試。這個系統可以圍繞科學家提供的研究目標生成假設,讓不同AI 智能體對假設進行討論、比較和演化,再把較有希望的方案交給科學家和實驗驗證。它在藥物再利用、新靶點發現等生物醫學任務中已經有所發現,但研究團隊仍然把它定位爲科學家的協作者,而不是獨立的科學發現系統。
而當AI開始提出科學問題,驗證也就不再只是給一個答案打分那麼簡單。一個候選假設可能要經歷多道驗證,快速計算或模擬、科學家判斷,以及真實實驗驗證,不同驗證方式的速度、成本和可信度並不相同。一次驗證得到的結果,還可能改變下一步要研究的問題。於是,計算、模擬、實驗這幾種不同形式的驗證,還會在研究的過程中連接起來,以不同方式組合。
PhAI Labs提出的發現驗證器(Discovery Verifier),就試圖讓不同的模型、數據、計算和實驗手段共同參與驗證,並根據研究進展決定下一步。它希望把驗證變成研究過程中的連續反饋。PhAI Labs進一步提出的五層協同,也是在嘗試把不同來源的反饋組織進同一個研究循環。
在這個框架下,發現基座模型(Discovery Foundation Model,DFM)關注的就不只是結果,而是完整的研究軌跡。系統不僅學習最後得出了什麼,還要記錄問題如何出現、嘗試過哪些路徑、哪些路徑失敗、科學家在什麼節點改變了方向,以及什麼樣的證據最終讓一個假設得到保留。這些連續的過程可以被組織成研究軌跡(research trajectory),成爲以後能夠調用的發現技能。
這就是爲什麼PhAI Labs需要科學家真正進入這個過程。9月15日,PhAI Labs發起DFM科學家合作計劃,該計劃邀請能夠提出重要科學問題、提供數據、代碼、計算或實驗條件,並參與驗證的研究者加入。合作並不要求一開始就有完整方案,科學家可以帶着正在研究的問題、已有材料以及自己的研究經驗進入,與AI共同探索哪些方向值得繼續。“我們希望讓AI學到科學家的品味,學到科學發現過程中的規律,以及那些過去難以量化、但語言模型如今已經能夠部分捕捉的規律。”吳英成說。
技術報告:
https://phai-labs.com/en/papers/sciencebuddy/GitHub:https://github.com/Gen-Verse/ScienceBuddy
產品入口:http://science-buddy.io/
PhAI Labs官網(亦可點擊文末“閱讀原文”):http://phai-labs.com