一句話讓AI生成遊戲,是真的還是吹牛逼?
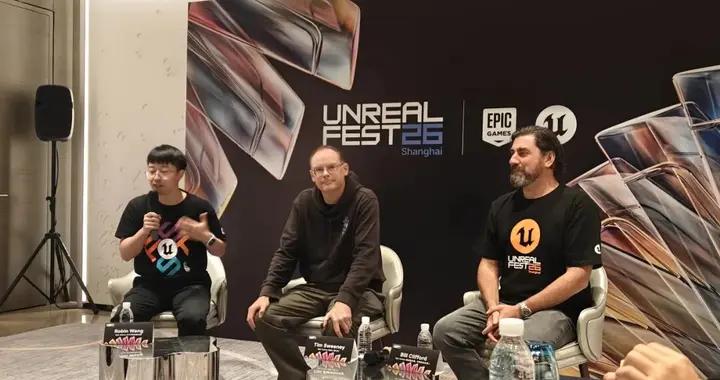
10月22日,在Unreal Fest Shanghai 2026上,月之暗面Kimi開發者關係負責人及高級研發工程師唐飛虎,帶來了主題爲「眩暈癱坐?一句話生成3A遊戲 哪些是真的哪些是假的」的技術演講。
還記得一兩年前,AI掀起第一波討論熱潮時,我身邊有些朋友對於「AI生成遊戲」這事持懷疑態度,甚至有人說這是泡沫——能生成,不代表生成出來的東西能被稱爲遊戲。
但如今,隨着AI大模型飛速迭代,懷疑的聲音逐漸變少。前不久,一項覆蓋Steam近5.4萬款遊戲的統計顯示,2024年新遊中披露使用生成式AI的比例爲10.9%,2025年升至19.9%,今年前7個月進一步達到30.8%。
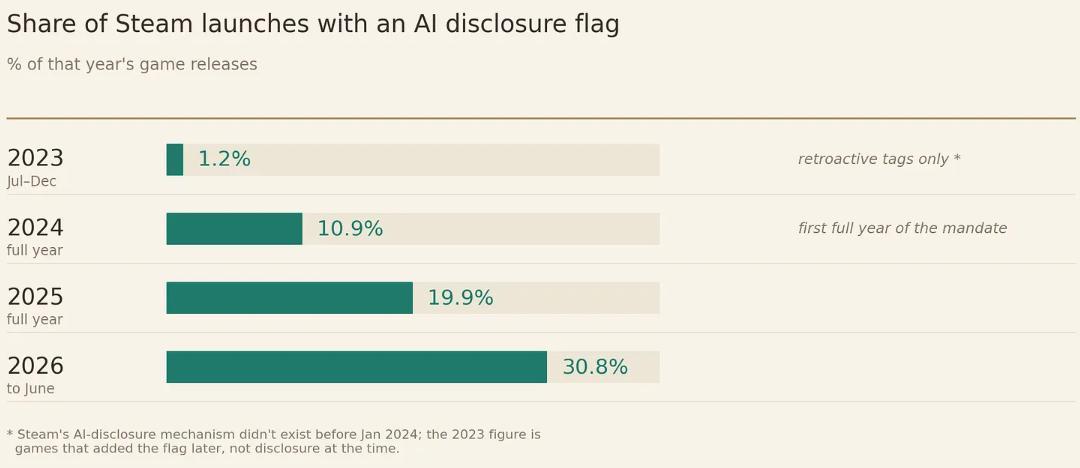
圖源Sulka Haro
毋庸置疑,AI生成在當下遊戲創作中變得越來越普遍。而承載這一變化的根基,在於AI大模型能力的不斷迭代。最早憑藉長文本處理能力受到關注的Kimi,如今也已經在AI編程、智能體執行復雜任務等領域有了更多佈局:今年7月,月之暗面發佈了擁有2.8萬億參數的Kimi K3,並重點展示了長程編程、遊戲及交互內容生成等能力。
這些變化對遊戲行業意味着什麼?唐飛虎提到,不同開發者對AI的掌握程度,正在拉開越來越大的產能差距——能接觸到新模型,或是能夠熟練使用模型的人,往往能花更少的時間,完成原本需要成倍工作量的創作任務。
不過,唐飛虎也表示,即便AI能大幅縮短遊戲原型的開發時間,最終決定作品能否脫穎而出的,仍然是開發者對遊戲玩法的理解。
以下爲唐飛虎演講內容整理,部分技術術語及口語表達經過轉寫與適當潤色,可能與演講者原意存在細微出入,僅供參考:
大家好,今天我想跟大家聊聊AI生成遊戲的話題:一句話讓AI生成遊戲,到底可不可行。
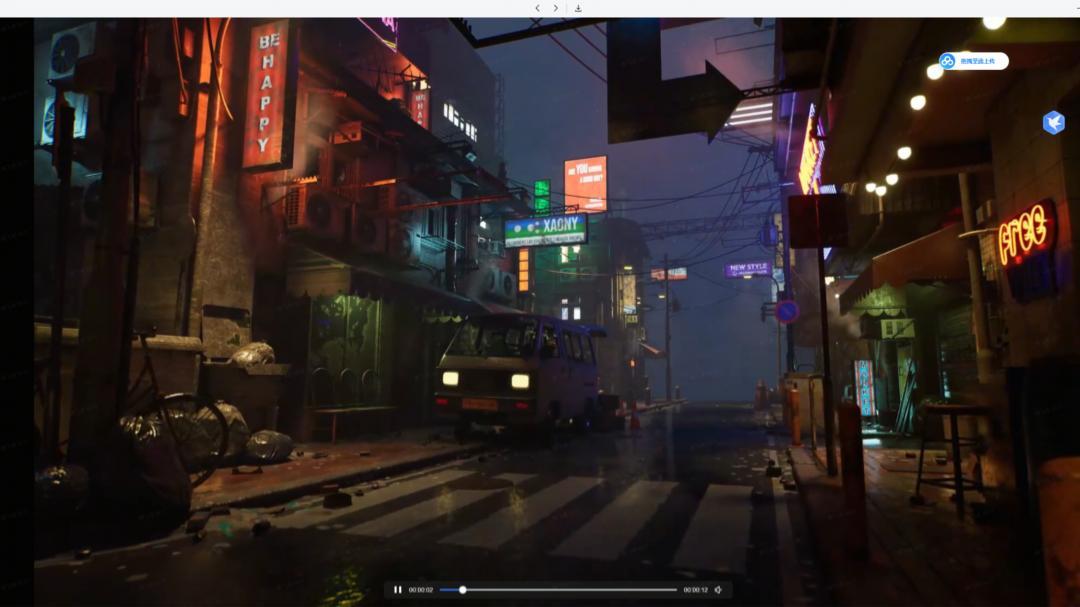
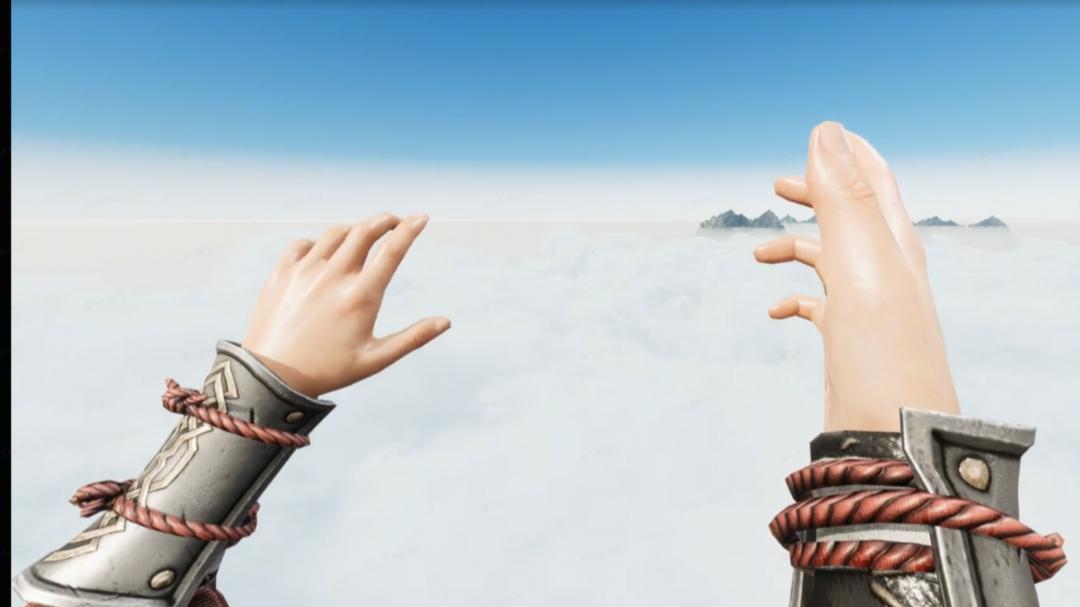
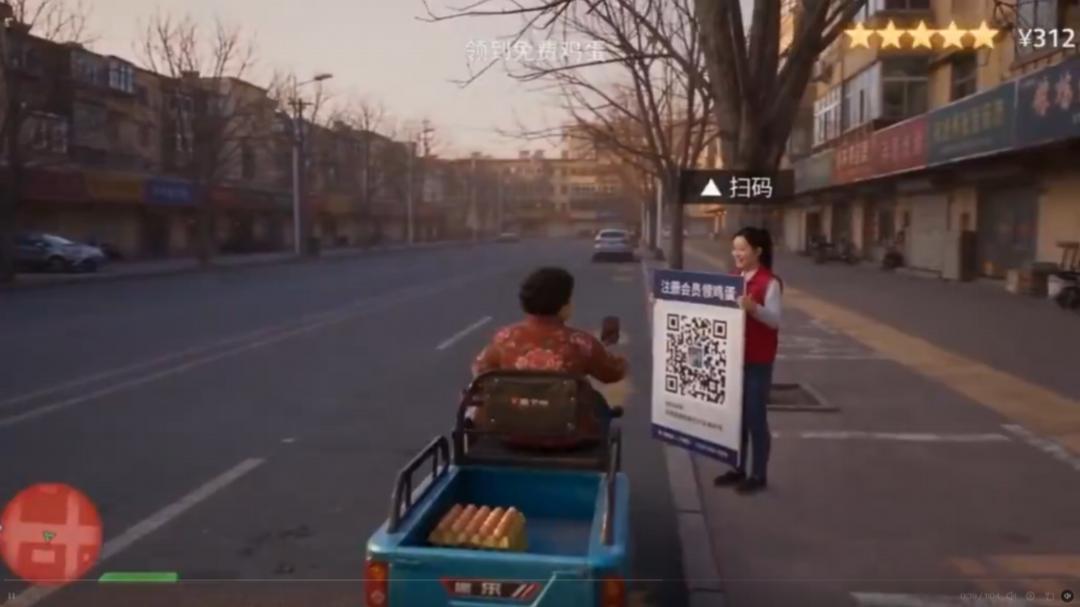
這裏先給大家展示幾個案例。第一個,是通過UE引擎製作的視覺特效,這裏的車輛會爆炸;第二個是第二個是我們團隊自己搓的一個Demo;第三個是「老奶奶GTA」,可能很多人在網上刷到過相關視頻;第四個是最近社媒上比較火的「小王子」作品。
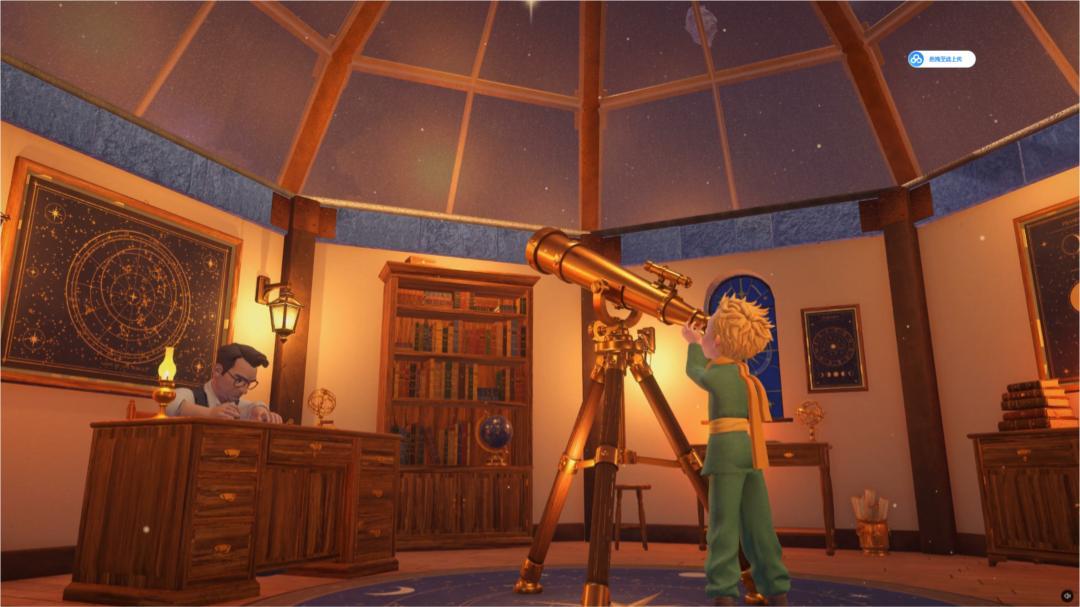
左右滑動查看
這幾個案例,哪些是真的?哪些是假的?哪些是一句話用AI生成的?哪些是用了一個星期、一個月做出來的?
在AI時代下,這些作品背後的工作量,變得不那麼容易確定了。像現在,網上鋪天蓋地討論的有兩種情況:一種是今天誰又把哪個Switch遊戲移植到了iPhone 上,或者是又把哪個PlayStation遊戲移植到了PC上;還有一種情況,是很多獨立開發者,對於把Demo視頻發到社媒上,變得越來越謹慎,因爲抄襲者就可能利用AI把你的玩法做完,趕在你前面把作品上架Steam,這是非常可怕的一件事情。
這些現象其實告訴我們,目前業內不同的創作者,對整個AI管線的掌控程度是參差不齊的。有些人會用到最新的模型,或者是內部模型;有些人則不屑於使用模型,或者可能他們使用模型的方法有問題,導致大家最終在產能上產程了非常大的Gap。
特別是在最近半年,這個Gap造成的差距,變得越來越明顯。
前Google首席科學家 Jeff Dean,在離職之前接受採訪時就提到,最近半年裏,他感受到的自己最大的誤判,就是他之前沒有料想到,AI現在能獨立運行寫那麼久的代碼。
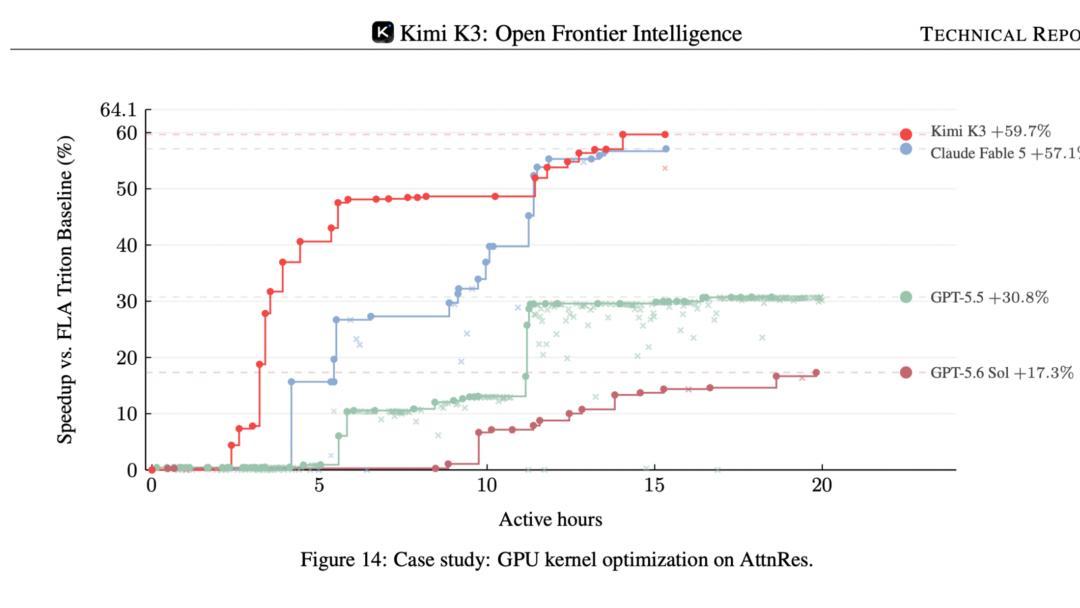
在我們的測試裏面,AI優化GPU的Kernel(內核)算子後,已經可以連續工作數十小時。
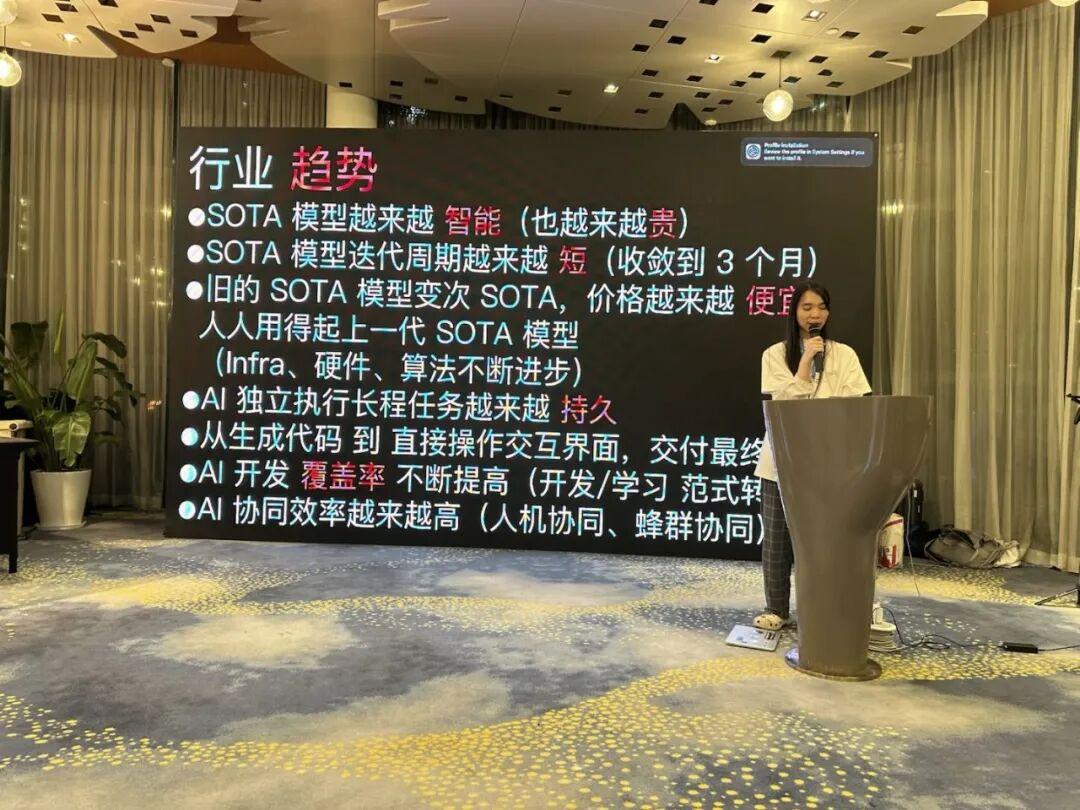
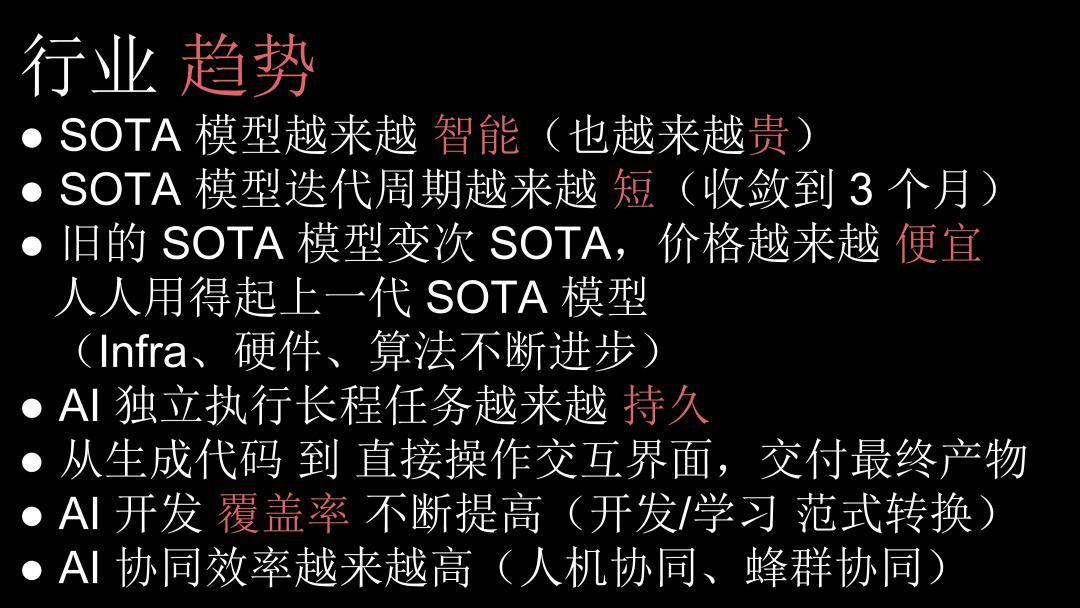
目前整個AI行業的趨勢,我覺得可以總結爲幾點:第一,SOTA模型變得越來越智能,最典型的例子就是最近AI解決了很多前沿的數學問題。
第二,如前面聊到的,模型迭代週期變得越來越短。我們創作相同主題的內容,可能隔兩週就得更新一次,因爲可能模型又更新了。
第三,之前的SOTA模型在不斷被下放,變成次SOTA模型。它們的價格變得越來越便宜,對應的,有越來越多人能用得起上一代SOTA模型。這是英特爾等芯片,以及算法的不斷的進步所造就的。
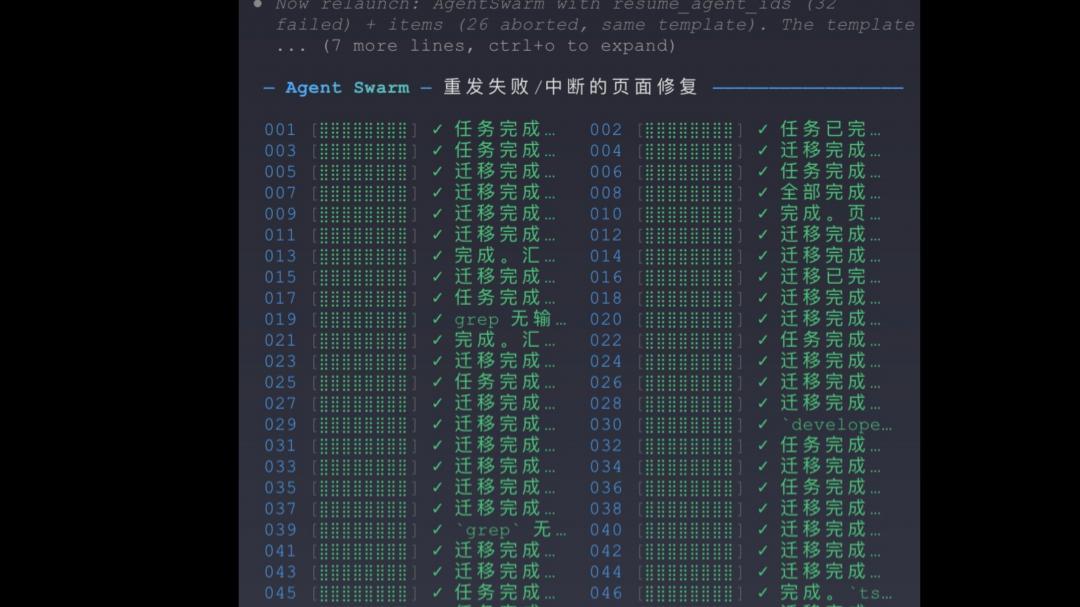
第四,現在AI模型能夠執行越來越久的長程任務。像這次活動現場我們演示的一個Demo,就是單個AI人力連續工作四天生成的,這裏面除去我們購買來的資產,剩下所有工作都是AI完成。
這個過程中,開發者大部分時間只需要下達命令,隔幾個小時來檢查一下,看看AI執行得有什麼不對的地方。相比於傳統開發模式,這顯然輕鬆了很多。這可能也解釋了爲什麼現在Twitter上能搜到海量的AI寶可夢、AI吸血鬼倖存者、AI自走棋遊戲。幾乎可以說,你能想到的所有玩法,都能在網上找到AI翻版。
第五,原先大家主要用AI生成代碼,但現在AI可以直接操作軟件界面,直接交付最終產物。它可以幫你做Slide、遊戲。
第六,AI開發的覆蓋率也在不斷提升。之前大家還會討論要不要自己手寫代碼,現在很多開發者則已經不去看AI寫的代碼了,而是去看AI最後交付的成果。
第七,AI協同的效率越來越高,這裏包括一些人機協同,以及AI和AI之間的協同。
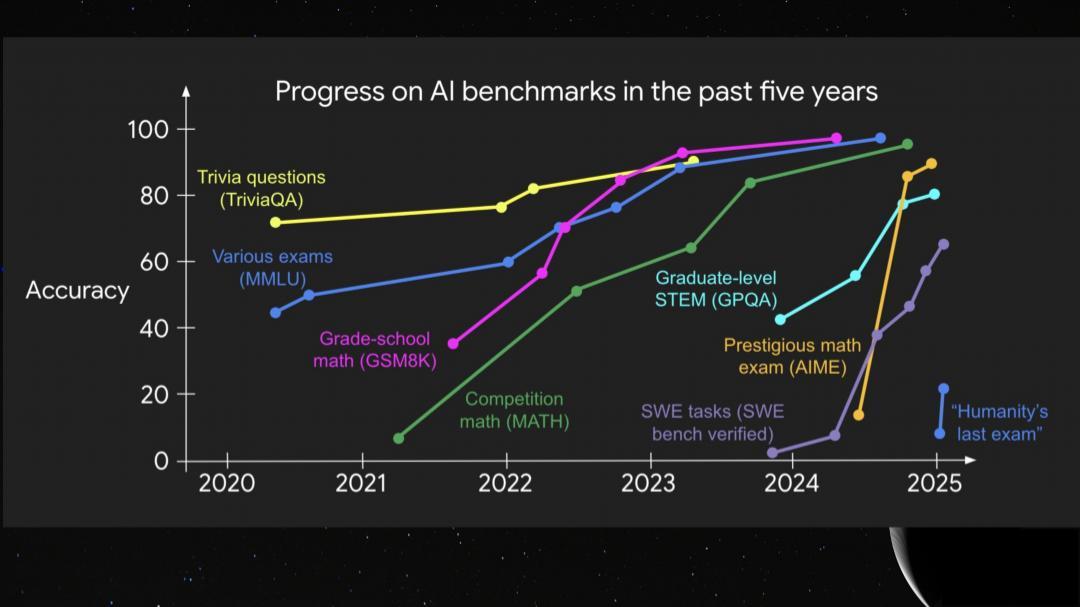
先來聊聊第一個特點:SOTA模型變得越來越智能。下圖列出了比較知名的benchmark,大家可以看到,隨着新benchmark被提出,AI解決問題的速度也在不斷變化。
像最近新出的Blender的benchmark,它專門用來測量模型在生成3D資產方面的能力。
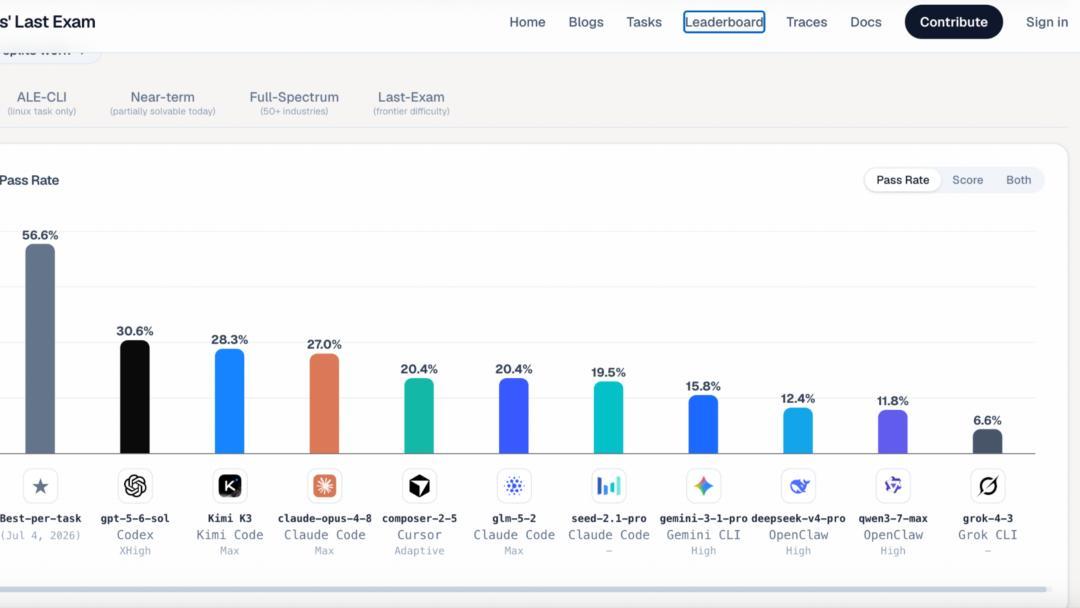
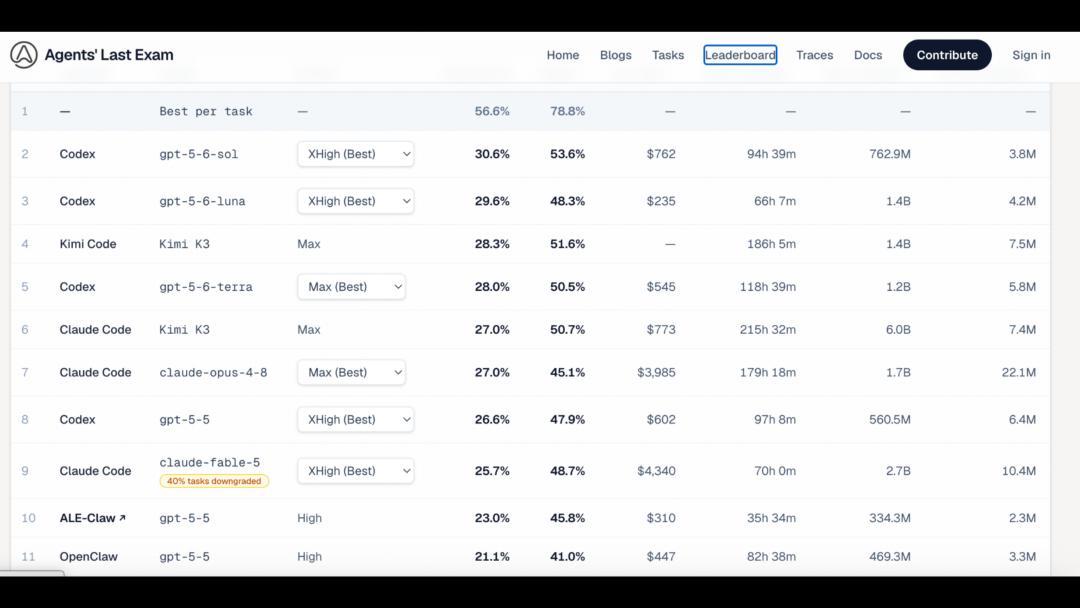
下圖是一個叫做Agents’ Last Exam的benchmark,它可以操作Unity、Unreal、Blender、FSLeyes等各種具體的軟件。
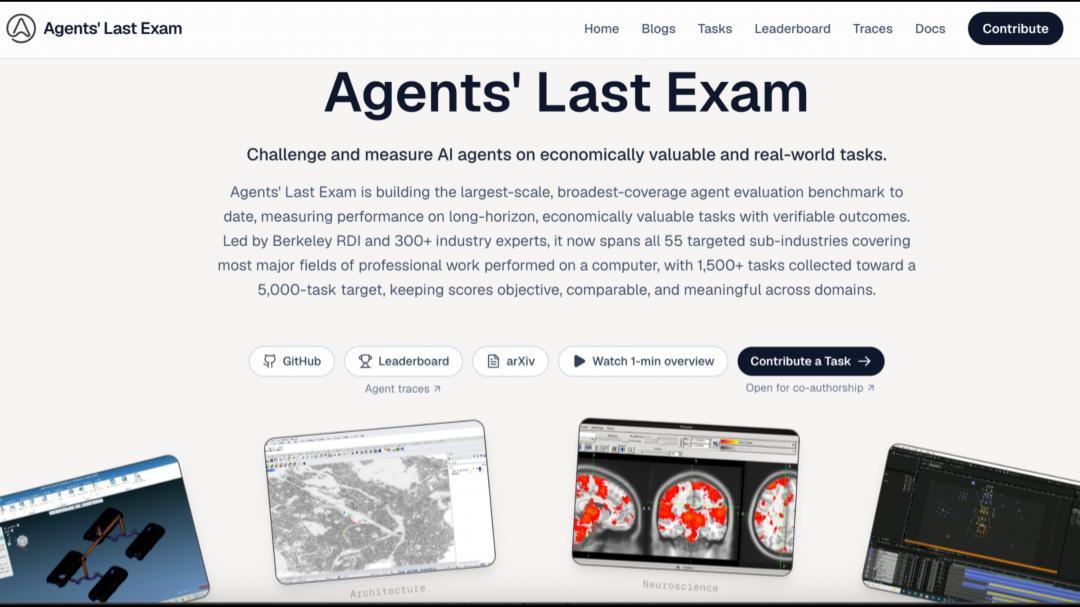
可以看到,這裏面的模型性能,也是在不斷變化的,Agents’ Last Exam測評模型的維度也在不斷的發生變化。它現在不僅測每個模型的最高得分,還會評估不同模型組合之後,執行任務花費的總價。
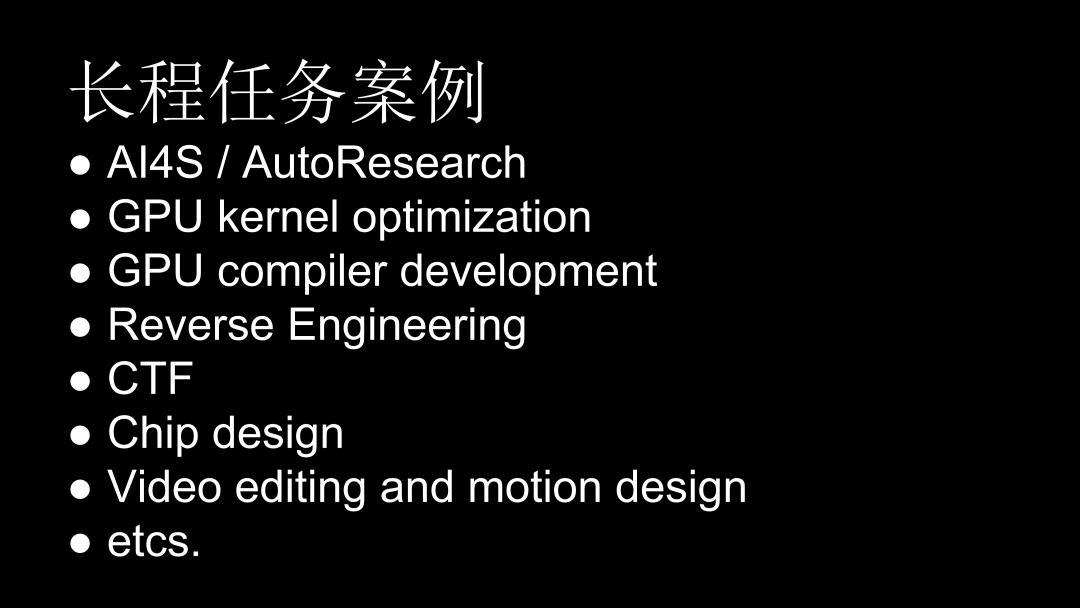
除此之外,其實還有非常多的長程任務案例,包括現在各種AI for Science,比如讓AI自己去發現定理;GitHub上有一個叫AutoResearch的開源框架,可以讓AI自動進行研究和實驗;還有像GPU Kernel優化、GPU編譯器開發,以及Reverse Engineering(逆向工程) 等任務——比較簡單的加密手段,對遊戲來說可能已經沒太大作用了,藉助AI和逆向工程工具,別人有機會把你遊戲裏的資產直接解包出來。
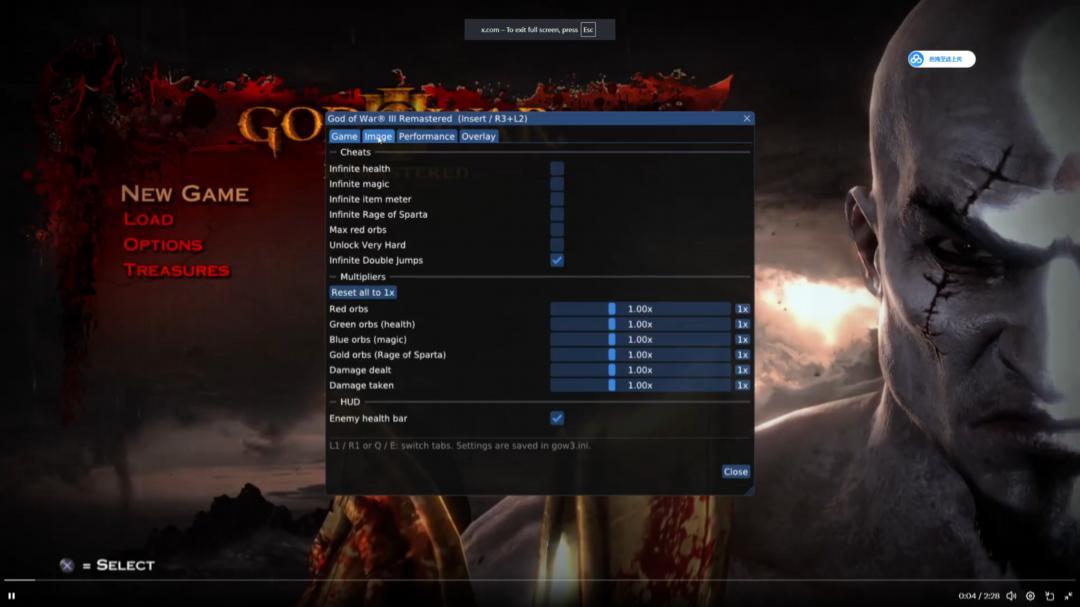
最近PlayStation上的一些遊戲,包括《戰神3》,已經被網友移植到了PC 上,而且獲得了更高的運行性能;還有一些Switch遊戲被移植到iPhone 上,甚至還產生了一些新的交互體驗。
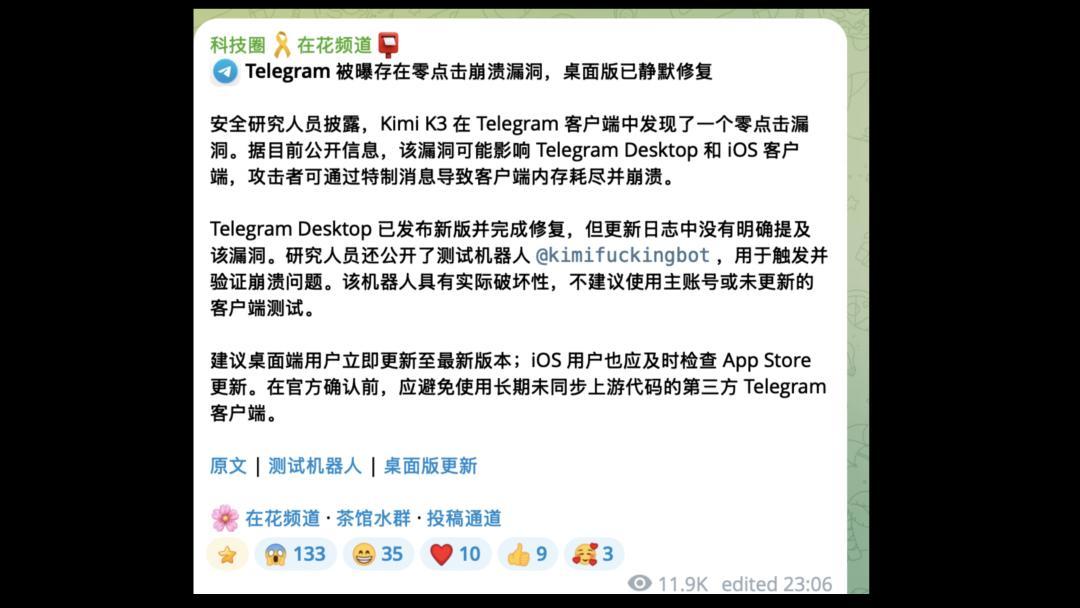
還有一個就是CTF(Capture The Flag,網絡安全競賽)。大家最近應該也有看到,網絡安全領域又出現了不少新的漏洞,有些數據庫公司遭到了攻擊。其中可能有不少漏洞就是藉助AI挖掘出來的。Telegram之前就用K3模型發現了一些零點漏洞。
除此之外,AI 也已經被應用到芯片設計、視頻剪輯等領域。
這裏有一個很有意思的現象:人類覺得難的問題,對 AI 來說未必同樣難。
比如優化GPU Kernel,這事對人類開發者而言可能相當複雜,相比之下,設計軟件框架看起來更容易;但在 AI 眼裏,前者反而更簡單,因爲Kernel的優化結果更容易驗證——改動對不對、性能提升了多少,跑一下測試就能知道,而一個軟件框架有沒有深層次的設計問題,可能要運行幾天,甚至用上一段時間後才能發現。
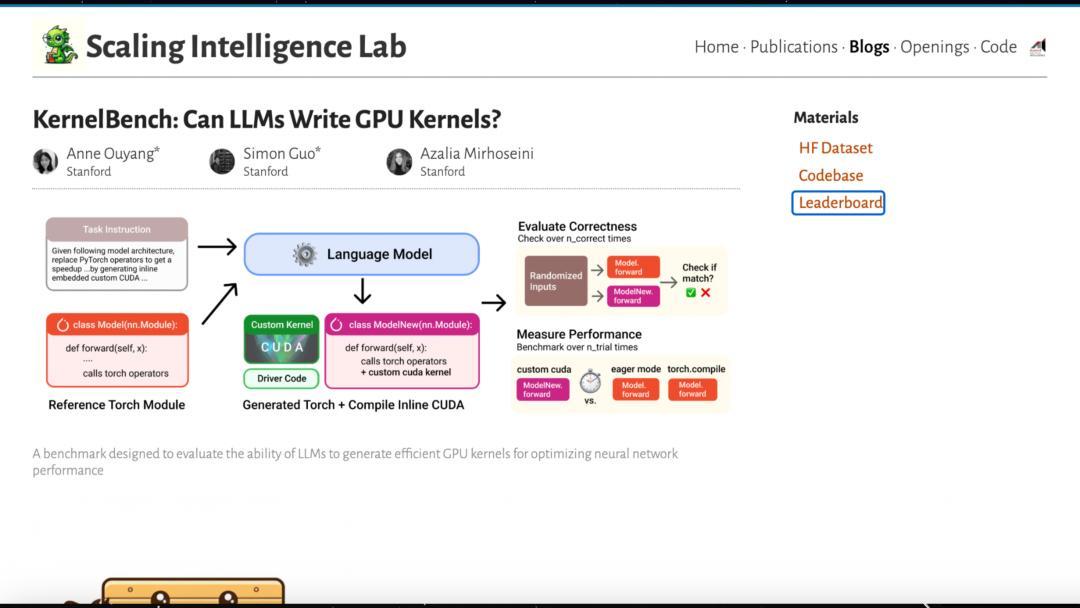
所以,人類衡量任務難度的方式,和AI衡量任務難度的方式,可能並不相同。一個關鍵區別在於,任務結果能不能被迅速驗證、量化。
像Kernel優化就是比較典型的例子。我們也在Kimi K3的技術報告裏展示了GPU Kernel優化任務的評測結果。
還有一個明顯變化,出現在算法競賽裏。去年,前沿模型與人類頂尖選手還各有勝負,而且模型往往需要專門設計的Harness來輔助。到了今年,模型在這類高難度編程題上的表現已經有了很大提升,部分任務甚至可以勝過頂尖人類選手。
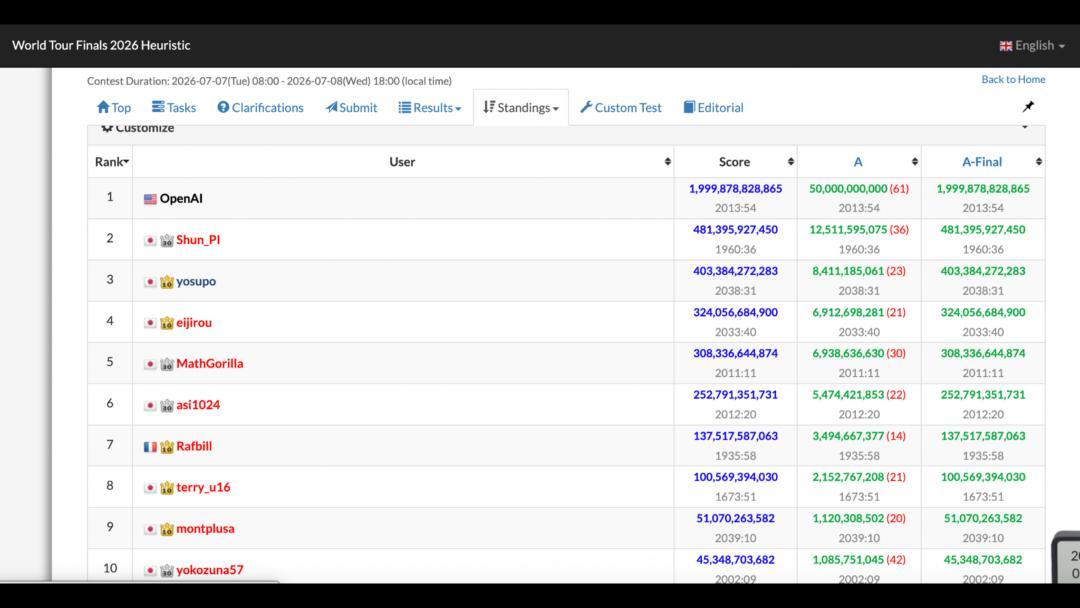
比如在今年AtCoder World Tour Finals的人機表演賽中,OpenAI的智能體就取得了非常突出的成績。大家從這張榜單也能看到,AI已經具備與頂尖選手正面競爭的能力。
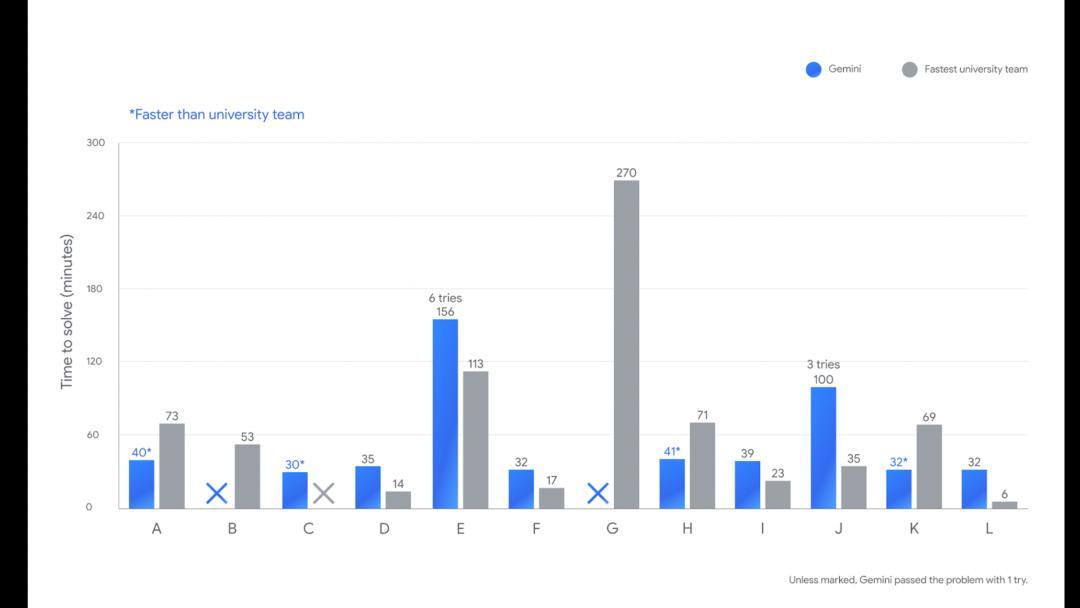
我還看到過一個很有意思的ICPC區域賽案例:據說出題人會用模型輔助審題、驗題,結果題目難度定得很高,參賽選手覺得不同難度的區分度不夠。有人就說,GPT都能做出來,爲什麼人類做不出來?這個例子至少說明,模型在解決高難度算法問題方面,已經達到了相當強的水平。
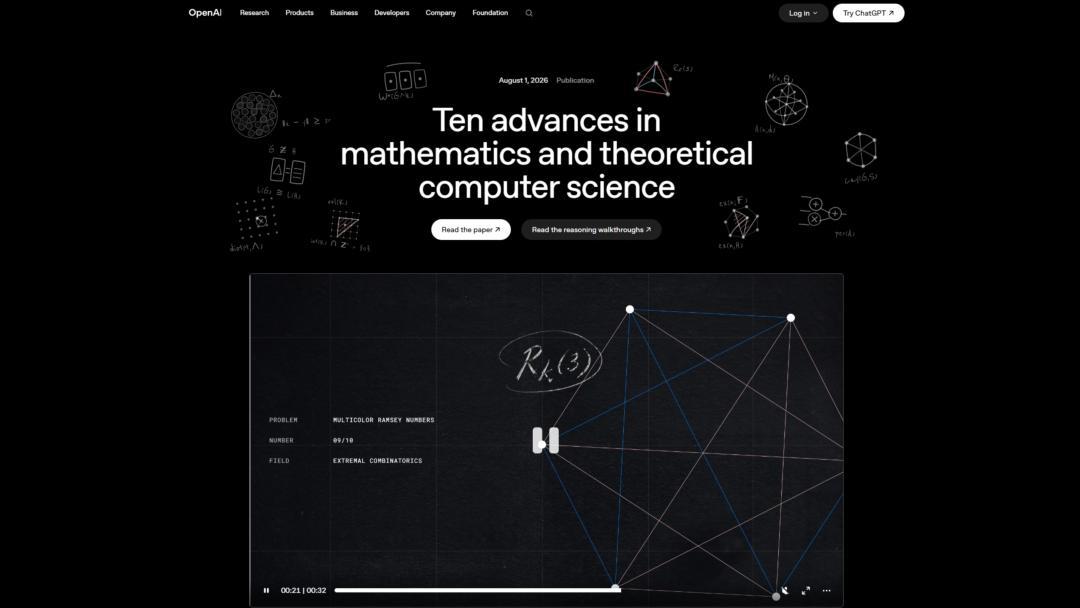
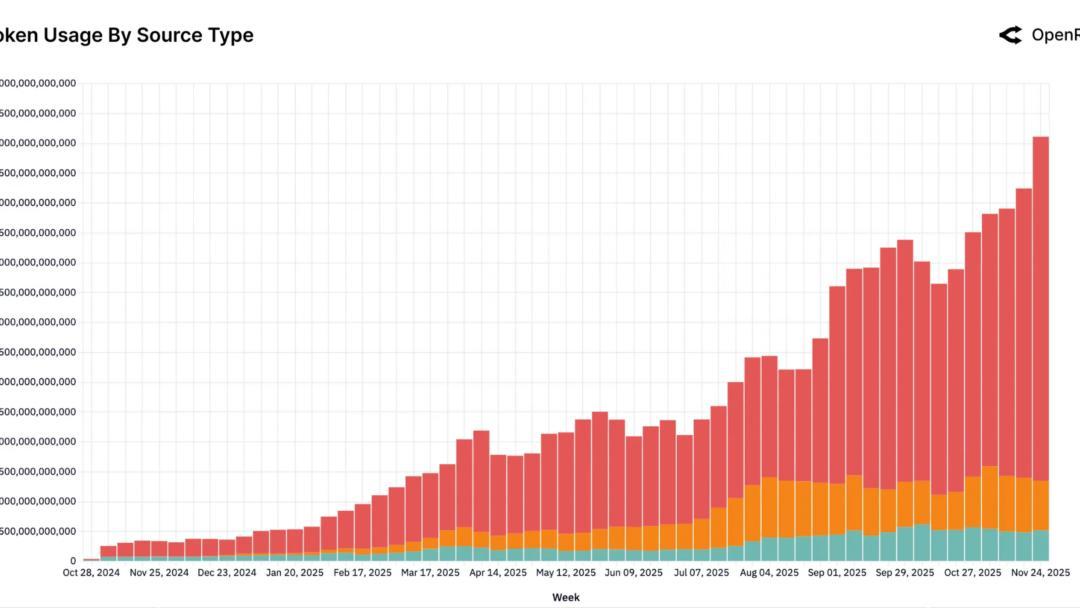
更厲害的是,AI已經開始參與前沿數學研究。比如OpenAI此前公佈過數學與理論計算機科學領域的十項定理進展。最近,圍繞千禧年大獎難題,以及與黎曼猜想相關的問題,也出現了AI參與的重要研究成果。
AI推進問題的速度,已經遠遠大於人類能夠應用的速度了。
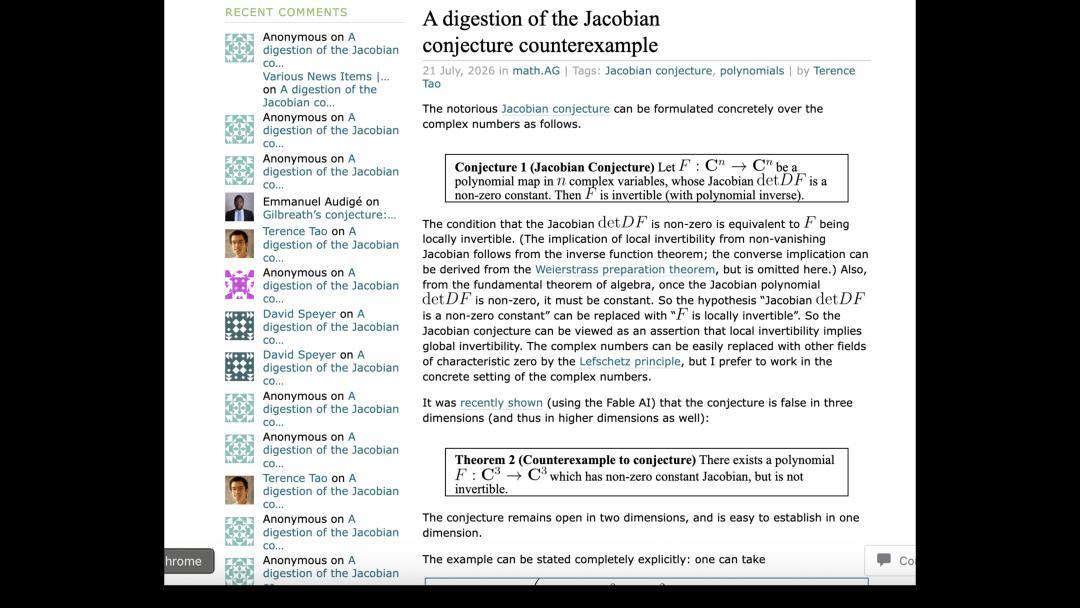
而且,之前發現這十個定理,需要大模型開一個智能體集羣,連續不斷地工作。但現在,大家用平常訂閱的ChatGPT Pro,就能在30分鐘內發現這些未知的數學定理和猜想。
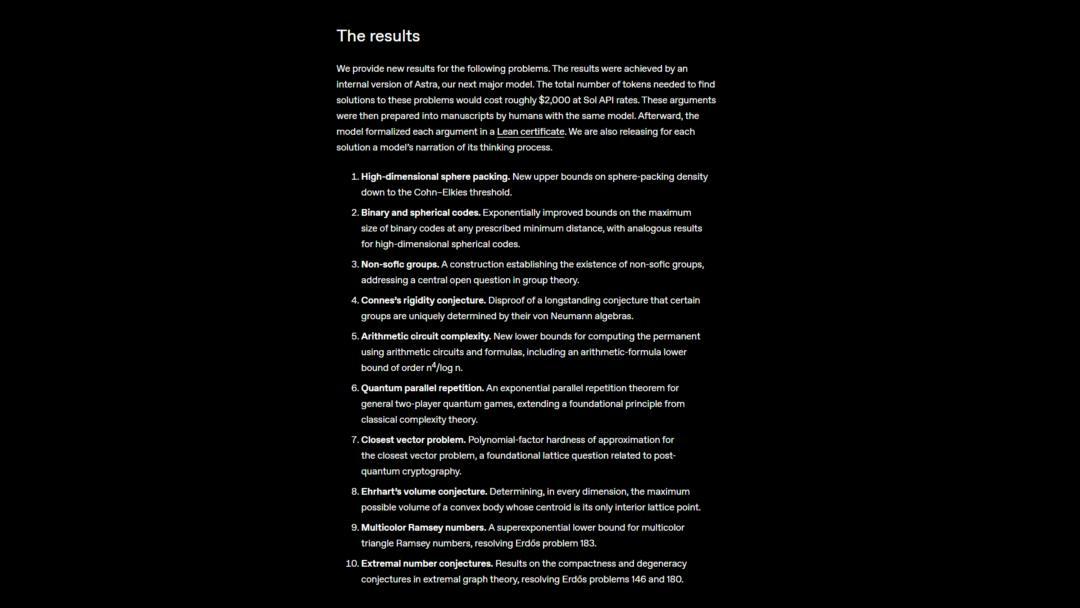
另一個趨勢是模型迭代週期越來越短。看下圖這張模型發佈時間線,大家應該能感受到,前沿模型接連推出,更新節奏比過去快得多。
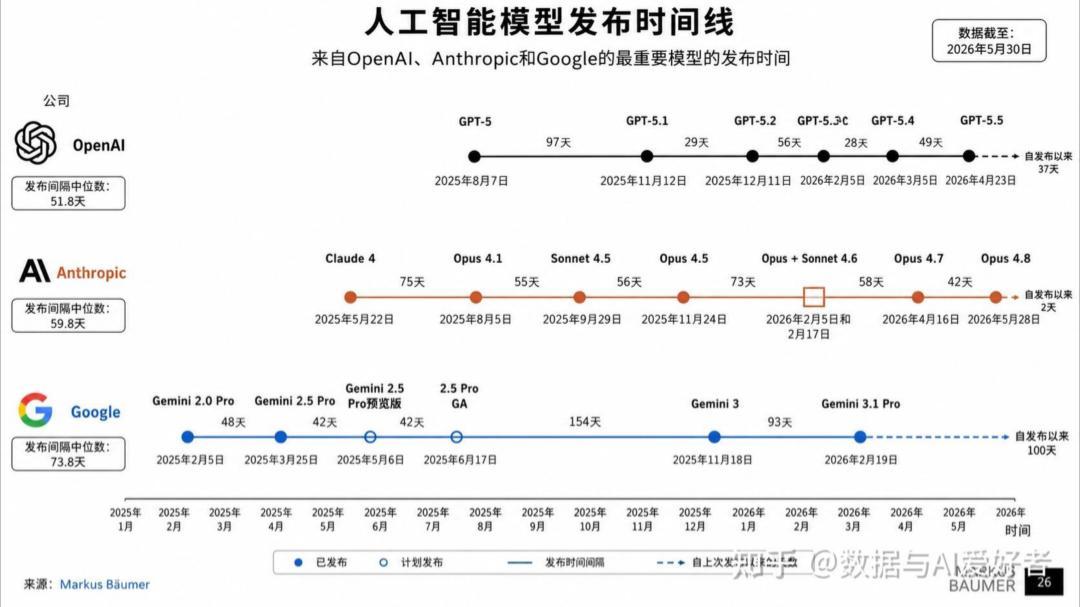
把模型的性能、價格放到一張圖上,看它們的帕累託前沿,變化就更明顯了。有的模型剛推出不久,就可能被新的模型在性能上超過,或者被價格更低、能力接近的模型替代。把不同時點的數據連起來看,前沿模型的位置變化非常快,開發者能選擇的模型也越來越多。
我們也看到一些開發者會組合使用不同模型。比如,讓Kimi K3這樣能力較強的模型充當Master Model,負責規劃、分配任務;再讓Agent調用更小的模型完成具體工作。這樣既能節省Token成本,也可能提高整體執行速度。
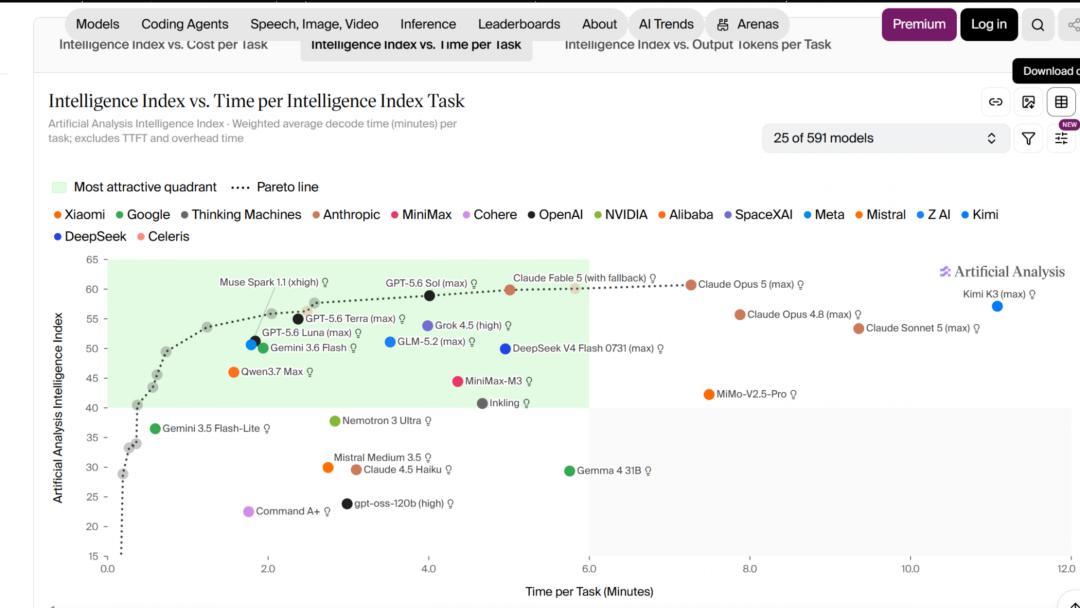
因爲Token越來越便宜,最近全網的Token消耗也顯著增加。以前成本高得難以持續運行的任務,現在可以反覆嘗試,也更容易讓多個智能體協同工作。
舉個例子,2022年,DeepMind在《Science》上發表AlphaCode相關論文,展示AI如何解決算法競賽中的編程問題。那時候,爲了解出一道題,系統往往需要生成、篩選大量候選答案,反覆採樣和測試,才能找到可用的解法。
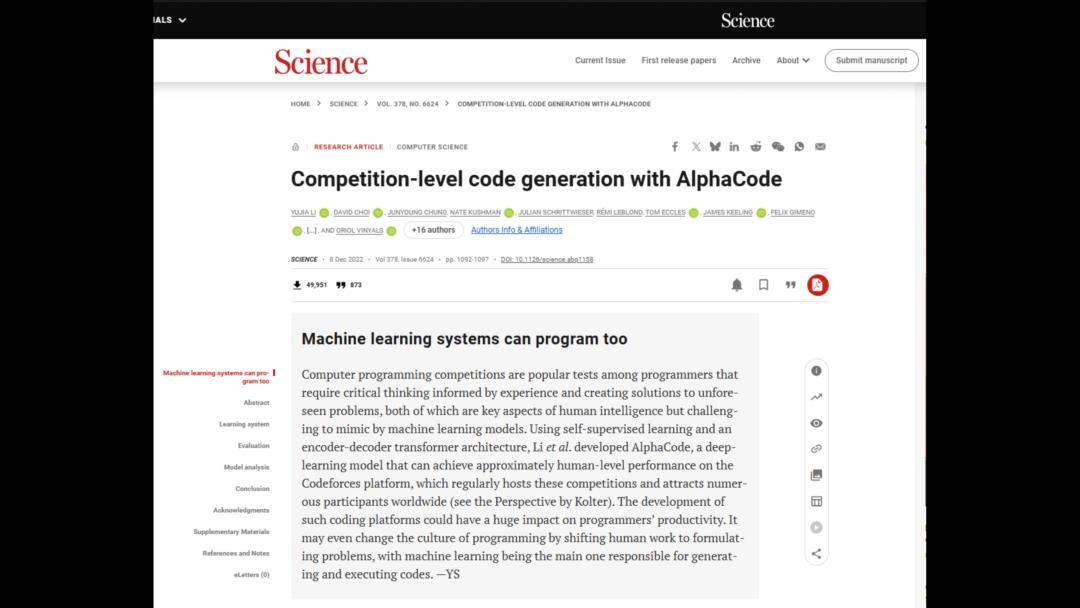
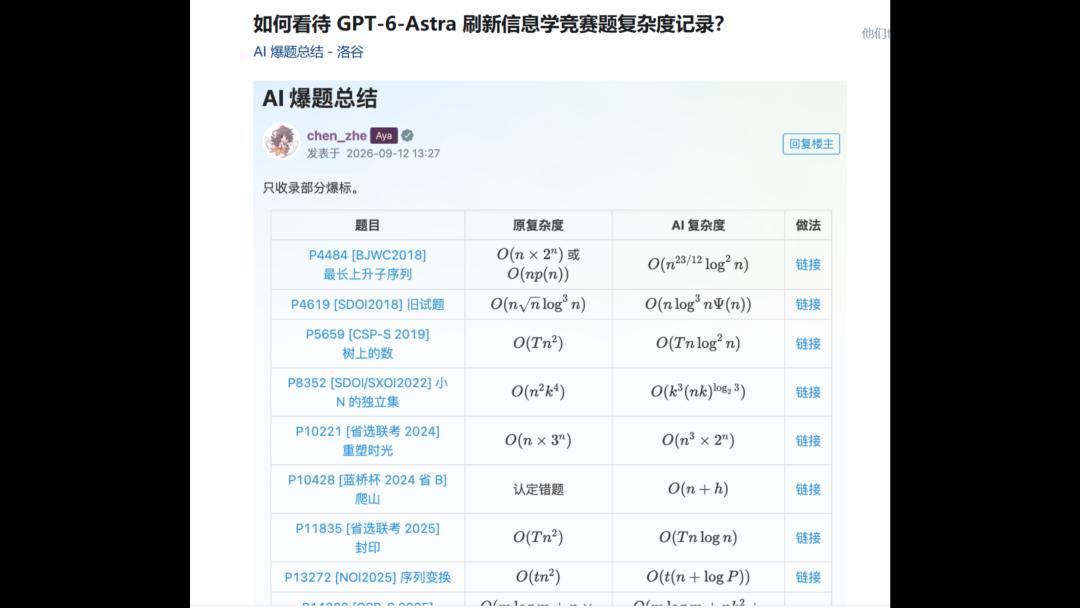
但現在,前沿模型已經能夠更直接解決不少類似問題。有時,它們還能找到原先連人類選手都沒有發現過的複雜度,用更好的視角提供新解題思路。
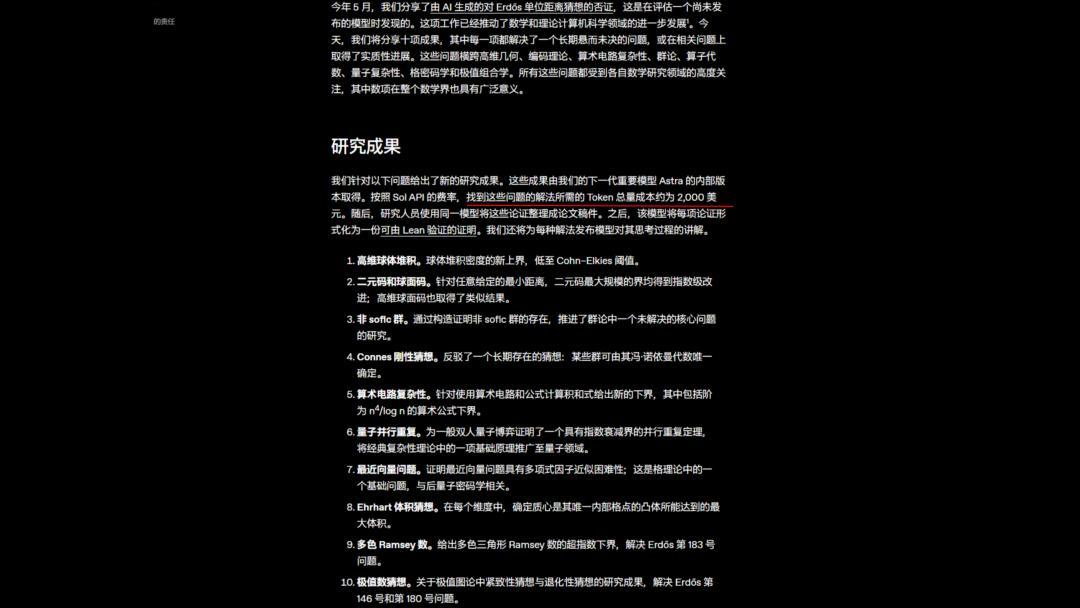
再看AI for Science的成本。OpenAI之前公佈的那十項數學與理論計算機科學研究成果,按照當時給出的估算,求解過程所消耗的Token總成本大約是2000美元,這是一筆不小的成本。
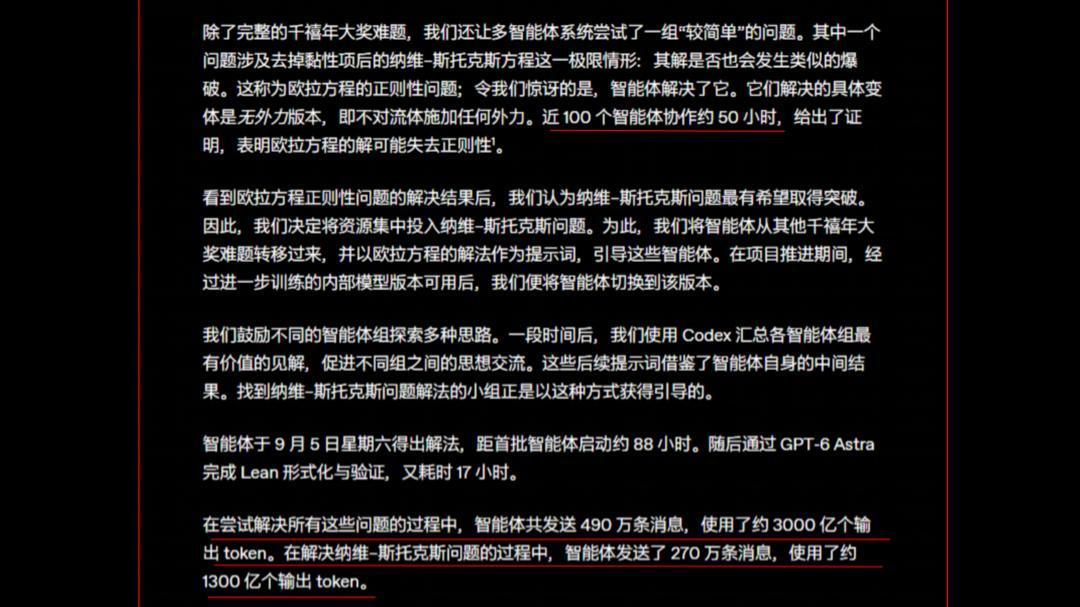
在更大規模的數學研究裏,消耗就更嚇人了。OpenAI曾讓近100個智能體協作約50小時,先在歐拉方程正則性問題的一個變體上取得結果,隨後又推進到納維–斯托克斯這一千禧年大獎難題。根據他們公佈的數據,僅納維–斯托克斯相關研究,就涉及約270萬條智能體消息、約1300億個輸出 Token。
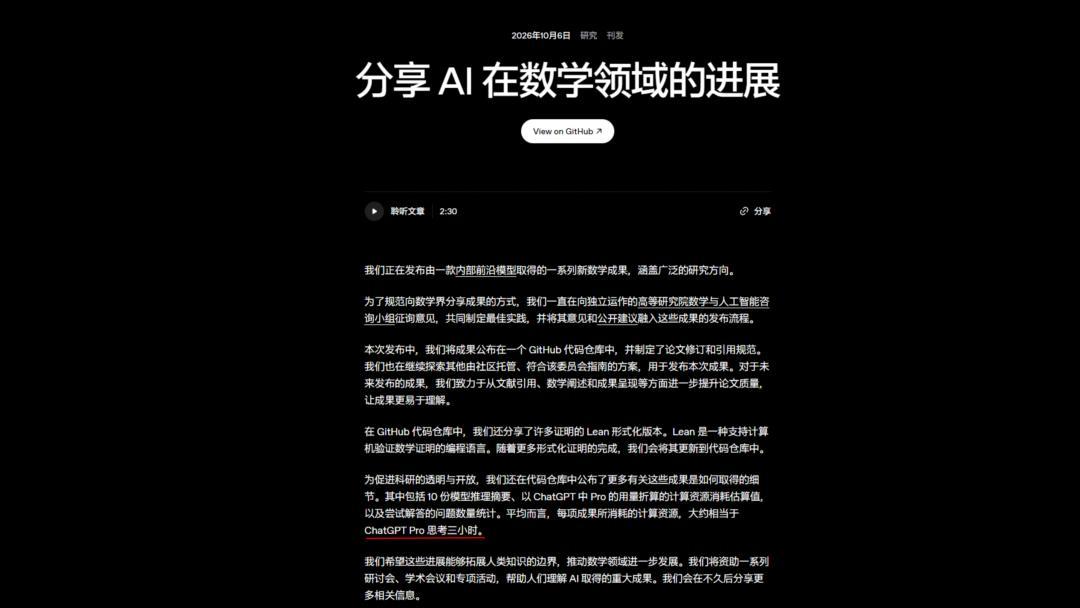
但到最近,OpenAI又公佈了新的數學研究進展。按他們提供的估算,ChatGPT Pro思考三個小時,就可以解決一個問題。所以模型能力整體是在不斷下放的。
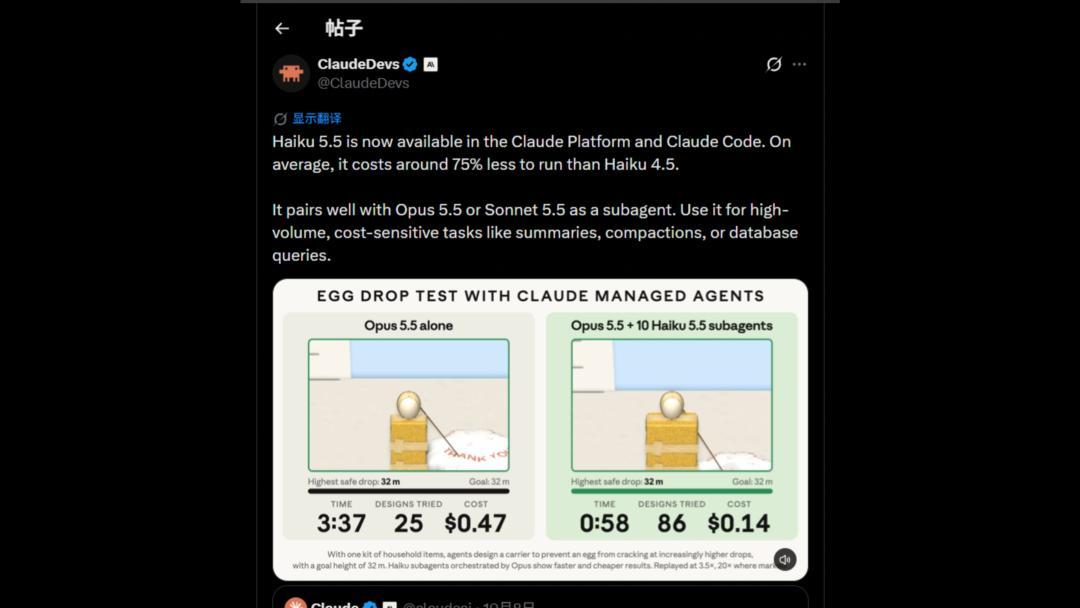
新的模型推出後,也能組合出更多協作方式。比如Claude Haiku 5.5這樣的快速、低成本模型,可以在一些子任務上配合更強的模型工作,從而降低整體調用成本、提高響應速度。
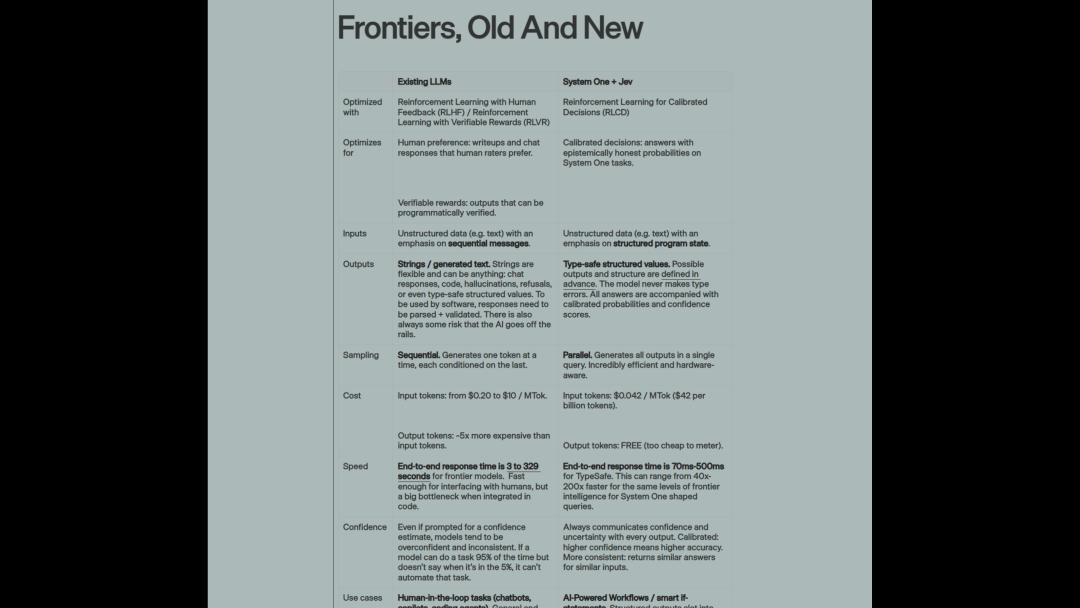
甚至還有一些走得更極端的路線。比如TypeSafe AI的Jev,它是一個System One決策模型,主要負責給出選擇、評分或概率等結構化判斷,而不是像傳統聊天模型那樣生成大段文本。在合適的任務裏,這種直接輸出決策結果的方式,可以減少開銷,提高系統響應速度。
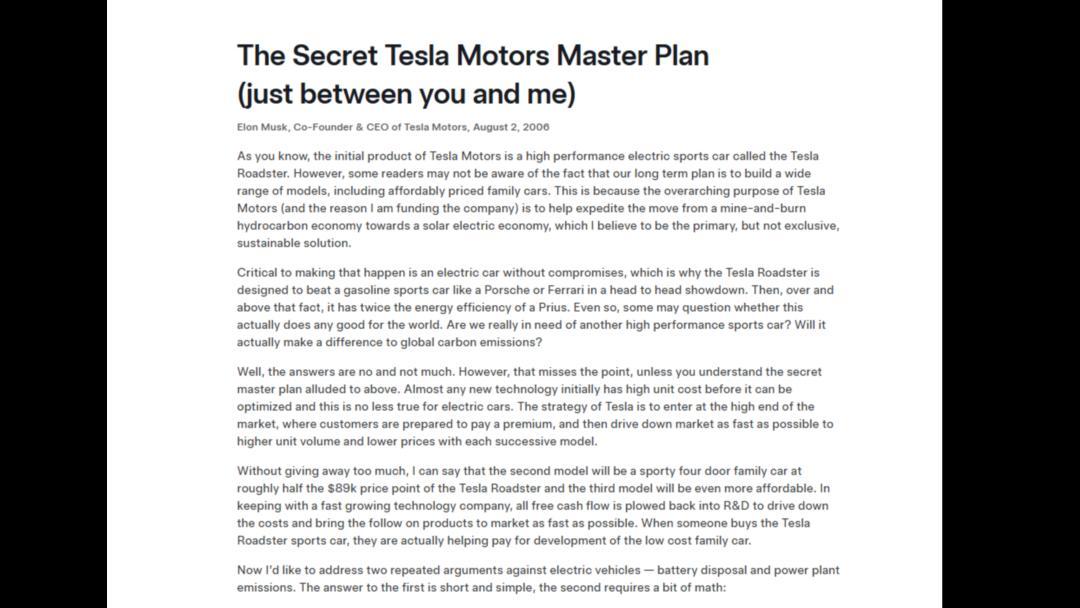
這種「先做出性能最強、成本最高的產品,再不斷優化,逐步降低成本」的路徑,其實並不罕見。比如特斯拉早年的標準說明書就提出,先造高價跑車,再利用積累的能力去生產更大衆化的汽車。AI 模型能力的普及,也有點類似的邏輯。
模型能力不斷進步,也在改變程序員、遊戲開發者的工作方式。這裏聊幾個遊戲相關的例子。
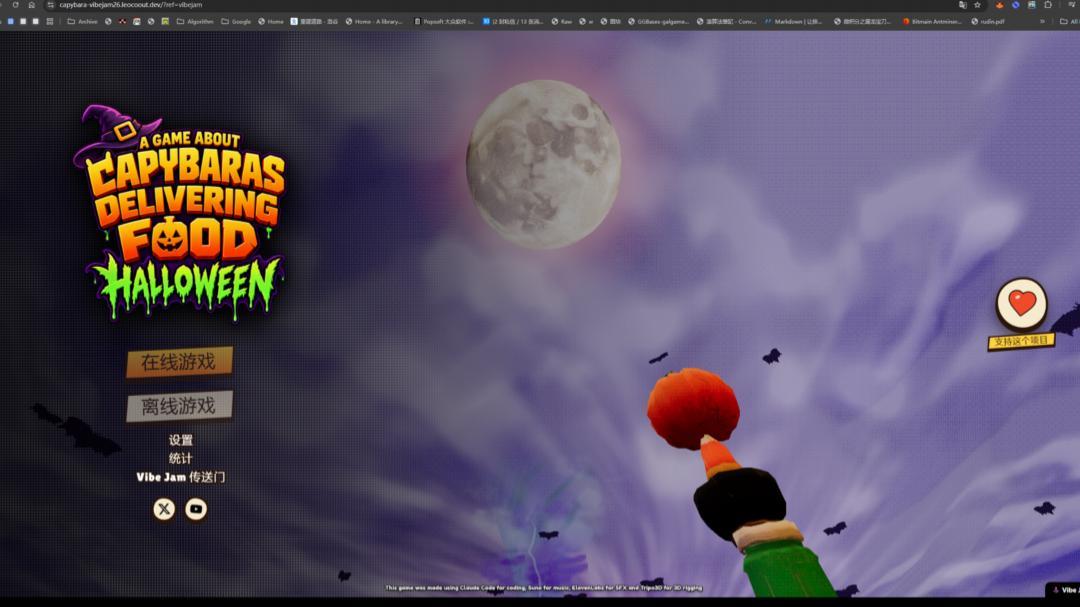
第一個,是今年的Cursor Vibe Jam 2026冠軍作品。它基本還原了《瘋狂出租車》的玩法,也帶着一些老式PlayStation遊戲的味道。不過它還嘗試做了一些更現代的設計,比如玩家可以單獨購買城市中的廣告牌,還有競價之類的設計。
先用AI快速製作原型後,再加一些小創意。這樣的創作流程,比較適合現在的AI快速生成。
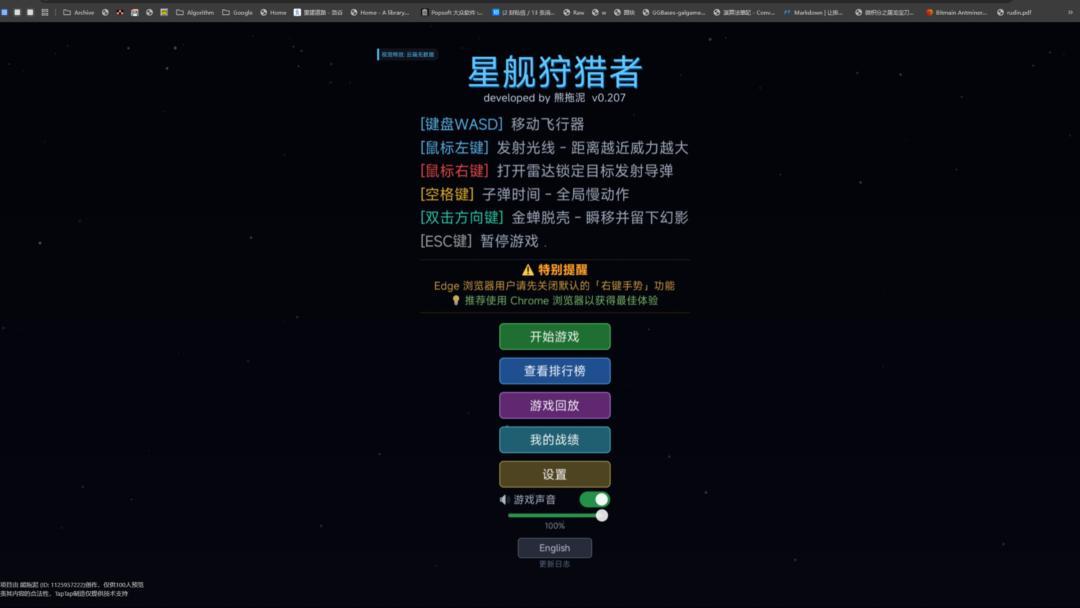
下圖是我朋友熊託尼老師做的《星艦狩獵者》。他在今年元旦前後,花了大約一個月在家裏完成了這款遊戲。這款遊戲不只有關卡編輯器,還有敵方艦隊編輯器。熊託尼先讓AI幫忙搭建編輯器,再通過編輯器調整關卡和艦隊,減少了每次都要用自然語言向AI反覆描述需求的成本,開發效率也隨之提高。
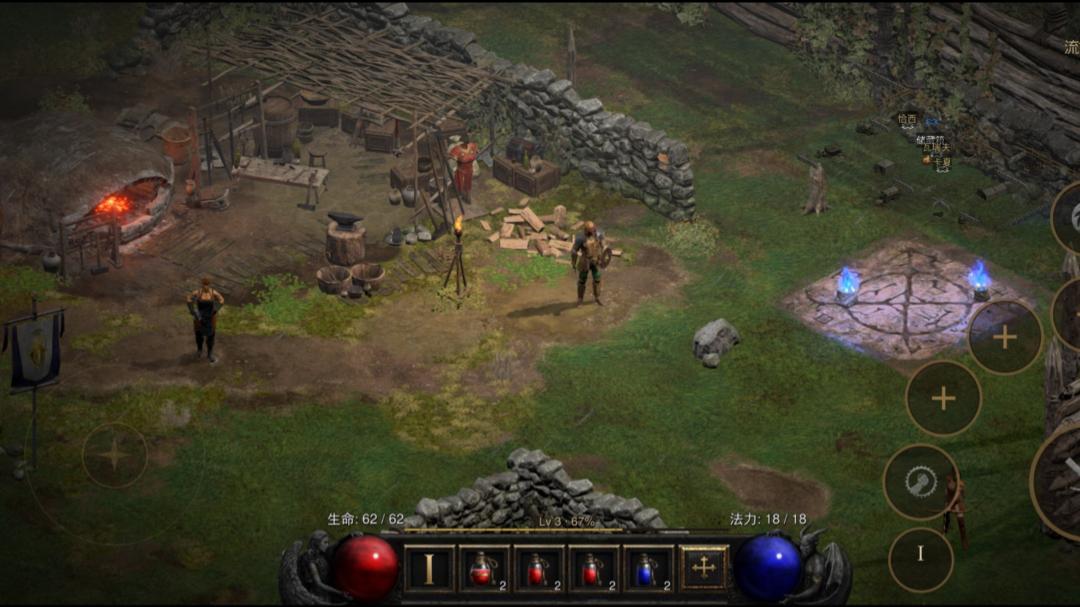
再看遊戲移植。現在已經有不少開發者和社區,藉助AI加快移植與原型製作。有人把 Switch上的《暗黑破壞神》版本嘗試移植到iPhone,也有開發者社區用類似方法制作自己的遊戲原型。
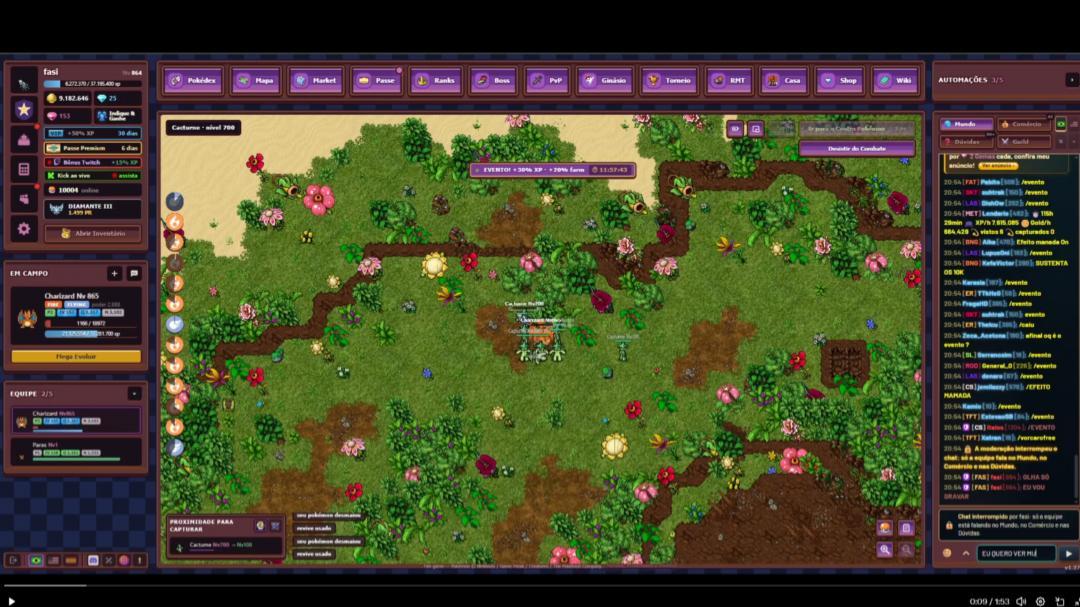
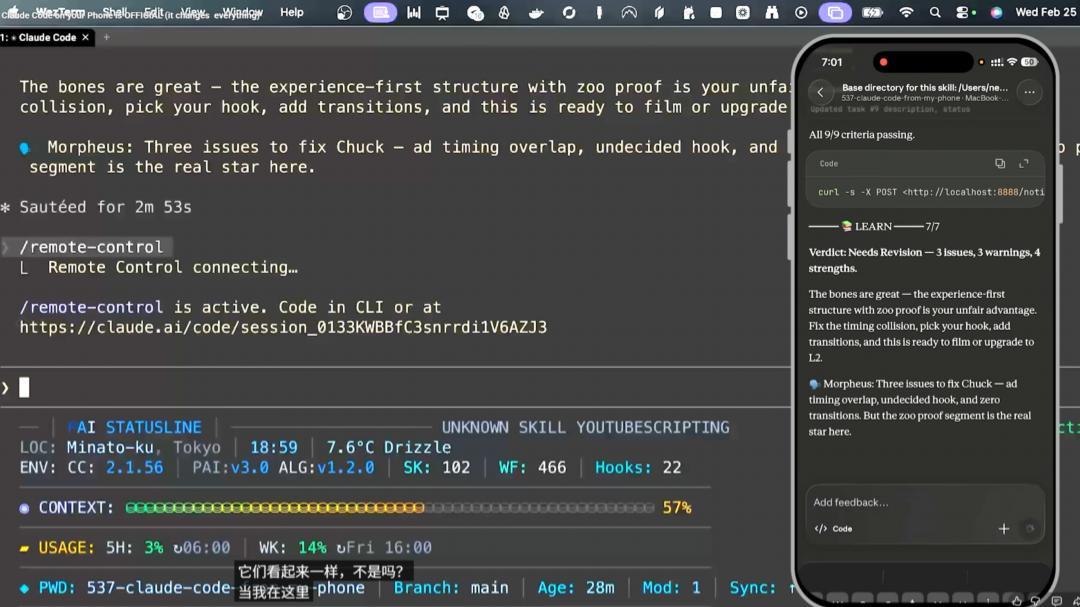
並且在這個過程中,開發者不一定需要掌握Coding技能。比如我們在這次Unreal Fest Shanghai現場展出的三款作品,就是由此前沒有遊戲開發經驗、也沒有寫過代碼的同事,通過和模型不斷交流做出來的。
開發者也不一定非得坐在電腦前。你可能晚上睡覺之前,直接在手機上給AI下達一個任務,到第二天再回來檢查它執行得怎麼樣。
最後,再回過頭看開場展示的幾個案例:
第一個汽車爆炸的視覺效果是真的,是我們團隊自己用AI做的,大約只花了兩個小時。
「小王子」也是真的,其創作者已經在社媒上公佈過自己的製作過程,他前後用了大概一個月,把作品打磨到現在的程度。這說明即便有了AI工具,要真正做出一款脫穎而出的作品,最後比拼的還是創作者對Gameplay的理解。你可以用一句話做出一個遊戲原型,但如果想把它打磨得更精緻,往往還需要投入大量精力。
「老奶奶GTA」是假的,它是視頻生成模型做的,儘管畫面看起來比較逼真,但它背後沒有一套真正可玩的玩法和代碼。
不過有意思的是,做完這個PPT後,我又在GitHub上發現一箇中國臺灣成員做出來的可運行版「老奶奶GTA」。他花了大約兩個星期。雖然模型精細程度沒有視頻那麼高,但確實實現了可以玩的Demo,還加進了一些新玩法。
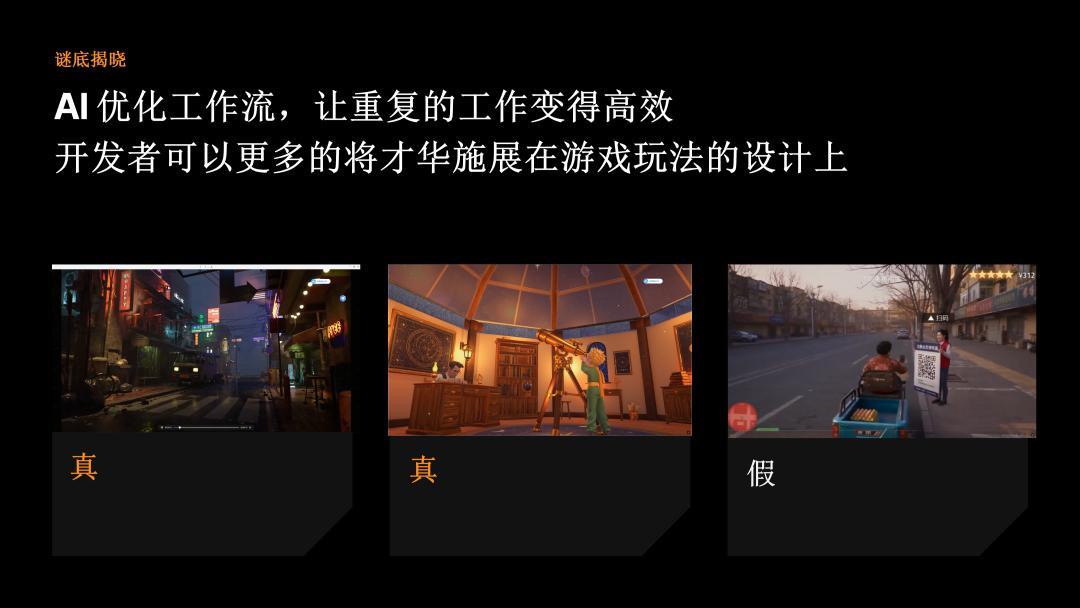
以上就是我今天想分享的內容。最後我想說,AI確實可以優化我們的工作流,讓很多重複性的工作變得更高效,讓許多獨立開發者把原來停留在腦海裏的Idea更快做出來。但對遊戲開發者來說,真正值得投入才華的地方,仍然是遊戲玩法本身的設計,仍然是你對遊戲的理解。
以下爲現場提問環節:
Q:不同模型的能力和使用場景不同,如何判斷用哪個模型最合適?
唐飛虎:不同模型擅長的事情很不一樣。雖然在前面展示的帕累託前沿圖上,有些模型看起來已經被新模型超越,但不意味着它們在所有場景裏都沒用了。我覺得最終還是要看具體的使用需求。
現在也有團隊基於已有模型,結合自己的數據和場景繼續訓練垂直模型。比如Cursor此前就以Kimi K2.5爲基礎,結合自己的數據與訓練流程,開發出了Composer系列模型。
所以哪種模型最適合,我覺得這個話題很像「小馬過河」:聽別人分析當然有用,但不如自己實際試一試,感受會更直接。
Q:你們內部是怎麼評估模型在遊戲開發場景下的能力的?
唐飛虎:第一,我們會看公開的Benchmark。現在針對軟件操作、遊戲製作等場景,已經有不少相關評測。
第二,我們自己也會直接用模型做遊戲,再拿這些作品和其他前沿模型的結果對比,看它是不是做得更快,最後做出來的內容是不是更符合玩家需求。
Q:AI理解問題的困難程度和人不一樣,比如我們不能理解底層機器碼,但AI不會遇到這樣的問題,那會不會未來AI把中間層的對接產物給逐漸淘汰掉?遊戲引擎會不會受到影響?
唐飛虎:很多中間層已經被淘汰了。比如有些開發者現在已經不再直接用高級編程語言寫代碼,而是通過自然語言指揮模型完成工作。那再過一段時間,學習某些編程語言還有沒有原來那麼重要?它們是否會像過去的一些中間工具一樣,被新的交互方式逐步替代?
我覺得隨着大模型能力持續提升、成本持續下降,編碼方式一定會發生非常大的變化。目前這在軟件開發領域表現得最明顯,遊戲引擎也可能經歷類似的變化。
Q:以前做貼圖、模型資產,往往要用專門的生成工具,現在可以用大模型直接生成內容。這種能力是模型通用能力泛化出來的,還是經過專門訓練得來的?你覺得以後大模型直接生成資產的方式,會不會替代專用工具?
唐飛虎:這取決於具體的使用場景。
大家可以看我的GitHub,我最近做過不少Vibe Coding小遊戲。有些遊戲資產來自現成的3D模型,有些是AI自己生成的,效果會不太一樣。
至於你剛纔問的,這種能力是泛化出來的,還是專門訓練出來的,我覺得最初主要是通用能力的泛化,後來通過進一步的後訓練,把這方面的能力強化了。
舉個例子,我前段時間做過一個類似《過山車大亨》的遊戲,裏面的角色、旋轉木馬、過山車、鬼屋等遊樂設施,都是模型自己生成的。它並沒有拿到原版遊戲的美術資產,只參考了一個開源版本的代碼。所以它的畫面風格、界面與原版很不一樣,但玩法卻相當接近。模型能在沒有原始美術資源的情況下,生成這麼多可用資產,我覺得已經挺有意思了。
再舉個例子,前段時間Steam上有一款圖書館整理遊戲很受歡迎,我就讓模型做了一個整理房間的原型,還可以切換不同主題。裏面各種室內傢俱,你還可以像玩《模擬人生》一樣,單獨往房間裏添加傢俱、調整擺放。
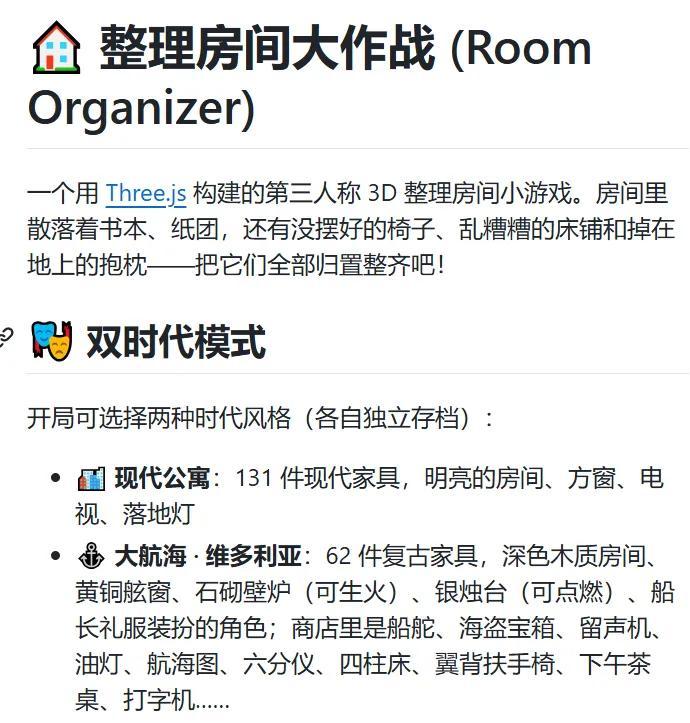
用AI來做遊戲原型,效率很高,能快速驗證玩法。等你確認玩法方向沒有問題,再用遊戲引擎、Blender和質量更好的資產去打磨作品。我覺得這可能是一種更適合當下的開發方式。