剛融資30億的AI公司,要給遊戲行業一點震撼
老實說,我過去對世界模型有過刻板印象,總覺得它是一門偏「糊弄」的技術。
高情商地說,它的畫面走意識流;低情商地說,提示詞一輸進去,像是在攪一鍋東西。當時還有同事吐槽說,所有世界模型都爛得平等……至少在那會兒的體驗裏,很多東西看起來不怎麼靠譜。
直到最近看到PixVerse R2的演示Demo,我才反應過來,世界模型已經不一樣了。
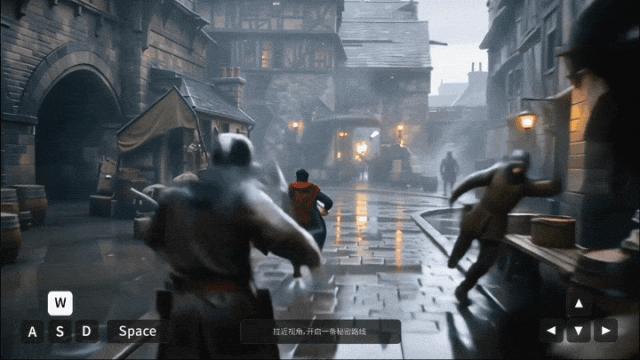
演示視頻裏,我印象最深的是一段送信任務,用戶一邊按方向鍵跑路,一邊打字說要一條密道。結果AI不僅生成了,還順手給密道配了個開門UI,我當時都愣了一下,反覆回看:這真不是魂遊的逃課路線?
推出R2的愛詩科技,在上個月剛拿到了由阿里巴巴領投,共計29.8億元的C輪融資。之前我們也分享過他們孵化的一款AI乙遊項目,項目背後還有前騰訊天美髮行製作人、前疊紙CTO負責孵化。
沒想到拿完融資才一個月,PixVerse又做了這麼大的迭代。從R1跑通可交互視頻,到現在R2真正可玩、可用,甚至在導演的監製下,R2能做到驚豔的「互動影遊」體驗。
趁着R2公佈幾段演示Demo和技術報告的節點,我們或許也該重新認識一下世界模型:它進化到哪一步了?又會給遊戲行業帶來什麼新影響?
01
世界模型進化到哪一步了?
話不多說,我們先看一下R2的演示Demo。Demo大致分三個方向:世界探索、故事劇情、角色交互。
其中,世界探索方向的Demo,展現了「低成本做遊戲」的可能。
首先R2給了一個響應更絲滑的「遊戲框架」。相比R1只能靠提示詞改變世界,R2額外加了鏡頭控制、方向移動、跳躍這些更具遊戲味的操作,且生成的延遲更低。比如修仙題材的Demo中,角色往前走,路隨之往前延伸,雲霧繚繞中場景漸隱生成,好像路本來在那裏。
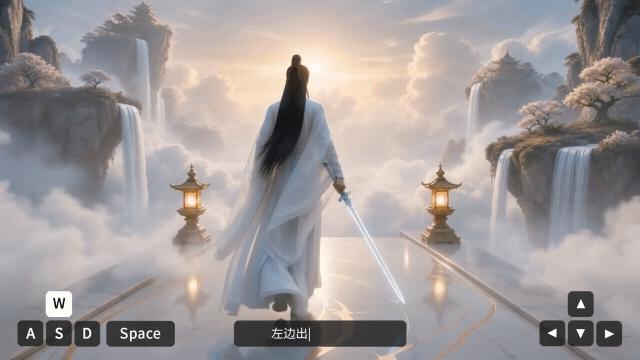
其次是能在框架中做玩法了。比如Demo裏有兩個連續的橋段。一個是角色轉彎看到牆上藏着的門,推開直接進了密道;另一個是輸入「衣服變成巡邏的樣子混入其中」,角色一秒換裝入戲。
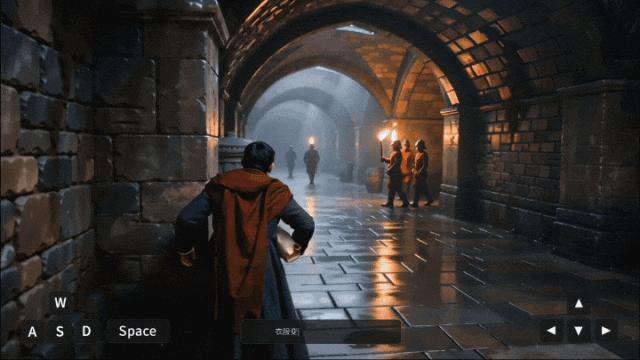
這個潛行僞裝橋段如果放在正經遊戲裏,設計師估計得鍵盤敲冒煙了,去做服裝、動作、交互,改角色敵對狀態……搞出一整套系統,才能保證玩家有不錯的體驗——但在Demo裏,只是兩句話的事。
故事劇情方向的Demo,則選擇了另一條「遊戲」路線:互動影遊。
Demo有明確的打Boss主線,路上會遇到各種狀況,AI會主動拋選項給你:是莽還是逃?該用什麼武器?你可以像玩互動影遊那樣只做選擇題,也可以自己輸入提示詞開新分支。這條路的未來發展方向,可能是一部畫面銜接自洽、分支管夠的實時互動影遊。
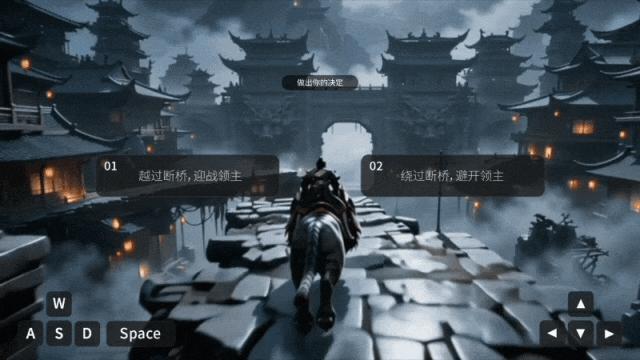
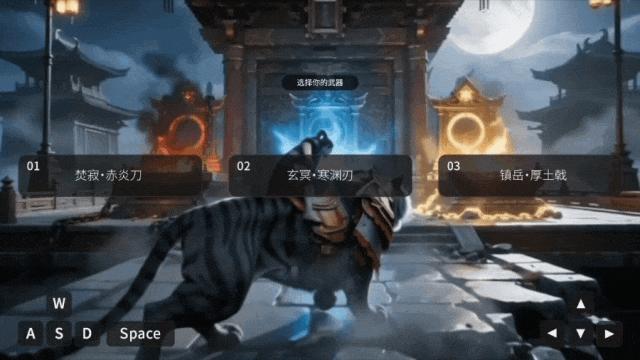
角色交互方向的Demo就更加特殊了,因爲它做的是真實自然的人物。
在直播帶貨Demo裏,用戶可以隨時文字打斷提問和貓糧有關的問題,主播說完當前這句會自然接話;
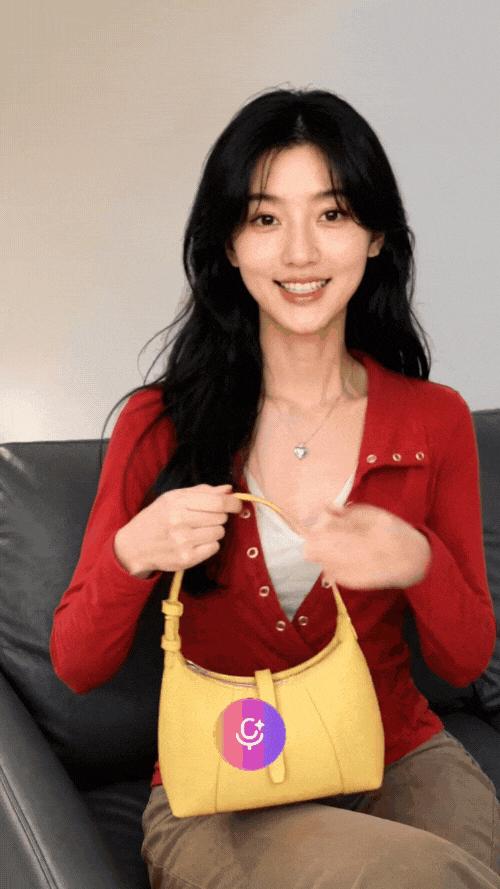
閨蜜交流的Demo裏,你發語音讓角色挎個包,她的動作神態也跟真人沒什麼兩樣。要知道,R2走的是視頻生成路線,每一幀畫面都是AI算出來的,不靠建模或預設動作,所以能做到真假難辨的地步,是一件可怕的事情。
視頻還做出了手持拍攝的輕微晃動感
據瞭解,Demo選擇真人出鏡的題材,是因爲這個方向最具挑戰,如果換成3D、2D動漫風格會更輕鬆。可以預見,它擁有陪伴類遊戲、虛擬偶像、文旅、電商等諸多落地方向。
看到這兒,可能大家還是有點迷糊:這樣的Demo表現意味着什麼?這樣的技術很強嗎?世界模型的進步到底在哪了?
關於強在哪裏,可以打個比方。大家覺得畫面很驚豔的視頻模型,像是把水凍成冰再雕成冰雕,造型上限可以很高,但一雕成就定死了;世界模型則是讓水一直流着,還要隨時把它塑成你要的形狀。
所以世界模型的技術實力和挑戰在於不同的維度,光看Demo確實很難理解,得配着R2的技術報告一起食用。
簡單來說,R2對管線做了大刀闊斧的修改,把管線從層層傳遞、層層折損,改爲一個多模態模型力大磚飛直接輸出,再將它直接蒸餾成實時版本——五層接力,變成了兩步直達。
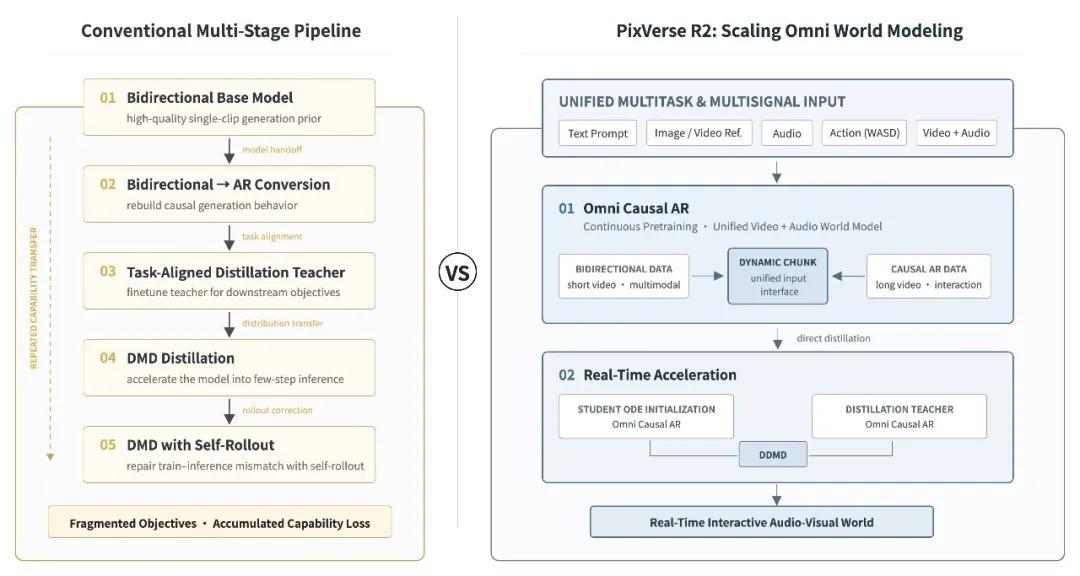
圖 1|舊式多階段Pipeline與 PixVerse R2 Scaling World Modeling對⽐:R2將能⼒擴展與實時蒸餾收斂爲Omni Causal AR和實時加速層兩個核⼼訓練過程,並在同⼀框架中統⼀多任務、多信號與⻓視頻建模。
基於新管線和框架,R2主要優化了三部分。
一是體驗更沉浸絲滑。
R2升級了多模態輸入,支持語音、文字、音頻/圖片參考、方向/鏡頭控制等方式,而且可以同時輸入——送信Demo裏你能邊跑邊打字,用的就是這個技術。
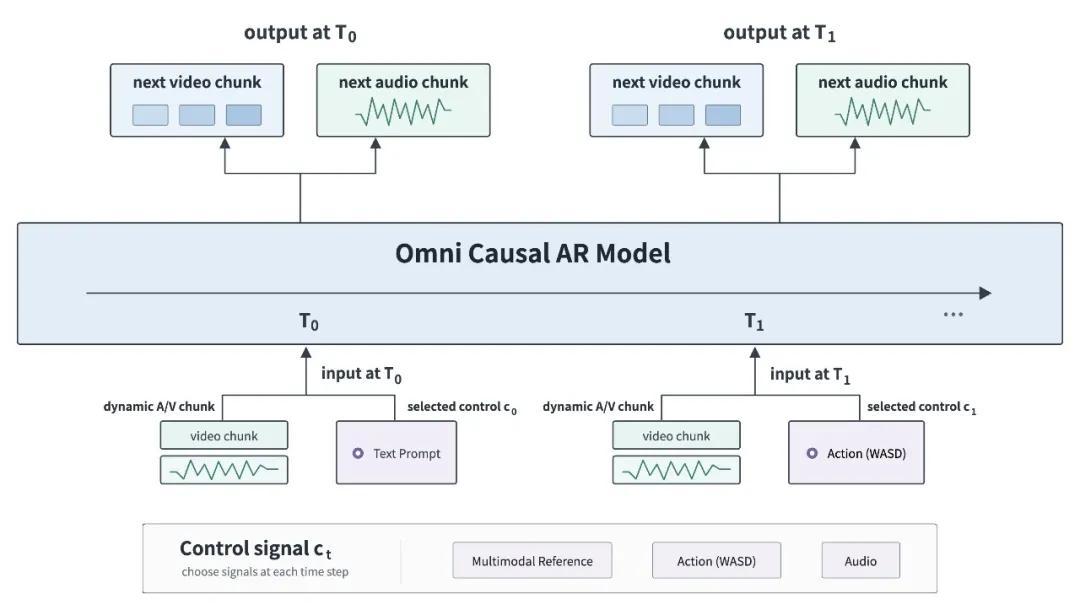
圖 2|PixVerse R2 Omni Causal AR:模型可以在運⾏過程中持續接收不同類型的控制信號;在每⼀個交互時刻,當前⽣效的信號與對應粒度的動態⾳視頻Chunk對⻬,並驅動下⼀段視頻與⾳頻⽣成。
在此基礎上,R2還會用Dynamic Chunk給指令分級。上下左右移動的操作需要毫秒級反饋和生成,複雜提示詞則需要一段完整的演出。提前把這些東西分好,AI就不用在反應和演出之間糾結。因此R2的生成延遲比R1大幅降低。
二是畫面更不容易崩。
R2的記憶系統分爲三層:Sink Memory儲存規則、風格、場景、角色這些長期錨點,決定世界長什麼樣子,類似編劇;Rolling History處理和優化動作、鏡頭等銜接,類似分鏡師;Object KV Cache儲存AI對這個世界的理解,類似場記。這三者協同,能在一定預算內,降低角色漂移、場景突變、跨段閃爍和動作斷裂等畫面崩壞的概率。
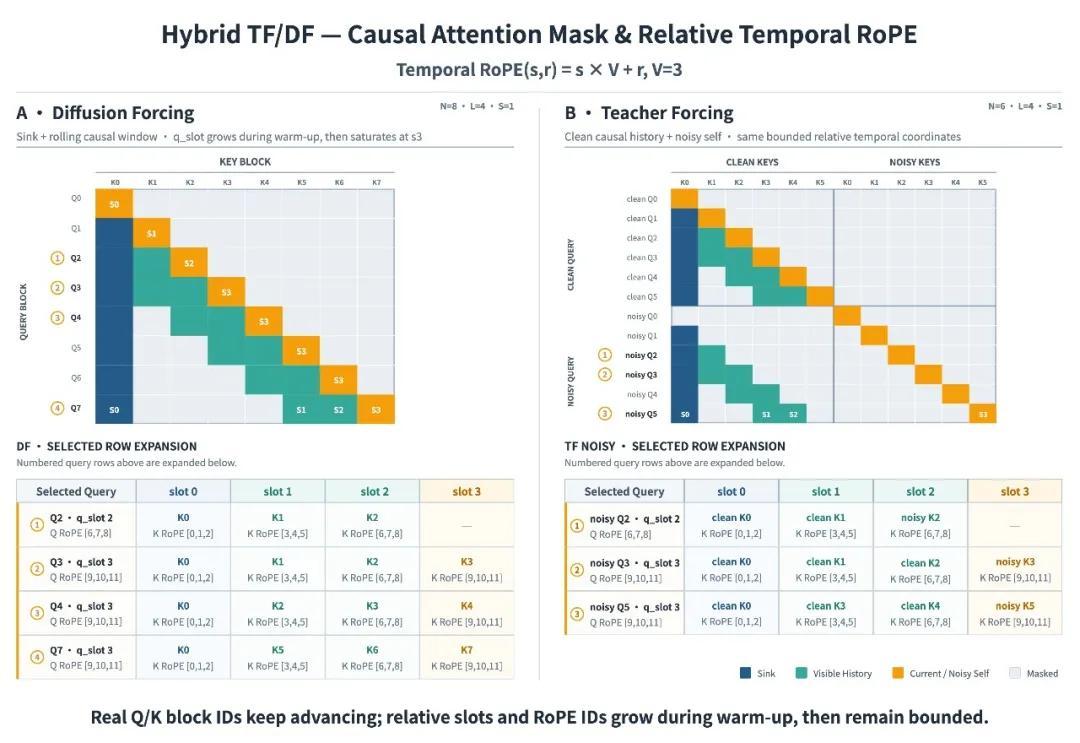
圖 3|Hybrid Teacher / Diffusion Forcing的統⼀Causal Attention Mask與 Relative Temporal RoPE。上⽅展⽰兩種歷史構造的因果可⻅性,下⽅通過編號⾏展開代表性Query的Q/K Block、 Relative Slot與RoPE ID映射,說明真實Block ID持續推進,⽽窗⼝內時間座標始終保持有界。
有意思的是,他們還會給AI飯裏摻沙子。
道理很簡單,你光給AI喂好的,那真實情況下給它稍微喫得差了點,反應就會特別大,畫面說崩就崩;光喂差的,輸出質量又上不去。所以把兩種內容按配比同時餵給AI,它纔有「耐受性」,出了小錯能自己穩住和修正。
據他們的評測,這套邏輯對亮度色彩漂移、靜止場景裏的錯誤運動、角色狀態偏移尤其有效。其中亮度漂移指標從約0.2降至0.13,降幅35.8%;29個長序列樣例中有20個獲得改善。
你可能也發現了,亮度、狀態、靜止時亂動這些問題,剛好是數字人最怕的崩點。R2 Demo裏那些真假難辨的角色,背後多半有這套記憶系統的發力。
第三,也是最務實的——省錢。
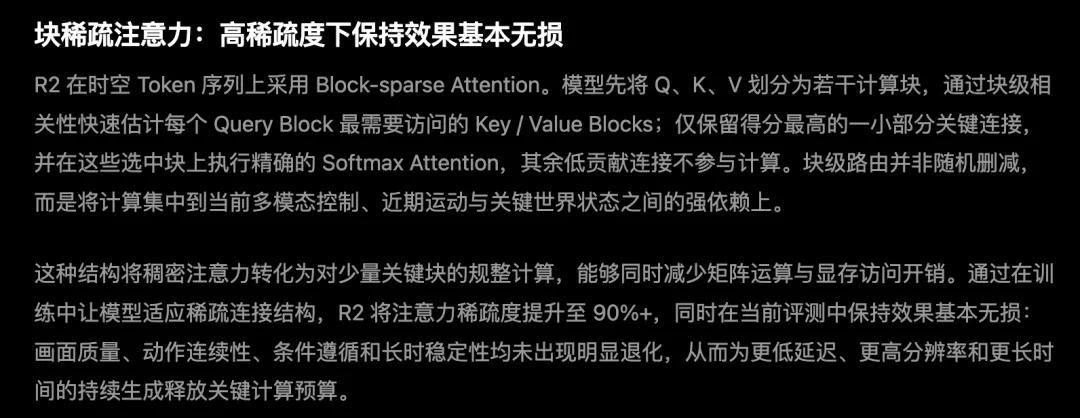
R2採用了Block-sparse Attention技術,讓AI只把注意力花在關鍵的地方,思路很像遊戲渲染裏的「看不見的不畫」。簡單來說,這一項把AI的注意力計算量砍掉了90%以上,但畫面質量、動作連續性、長時穩定性沒有明顯退化。
另外還有Pyramid Ultra-few-step Distillation技術,先用低分辨率打底,確定場景、運動和鏡頭,再用高分辨率精修紋理細節,類似遊戲研發中的「白模-貼圖」環節,讓AI生成的延遲更低、重複計算更少;DDMD的正則對抗,保證在極少的生成步數下,指令響應依然精準、畫面依然精細,給「兩步直達」的管線兜住了質量下限。
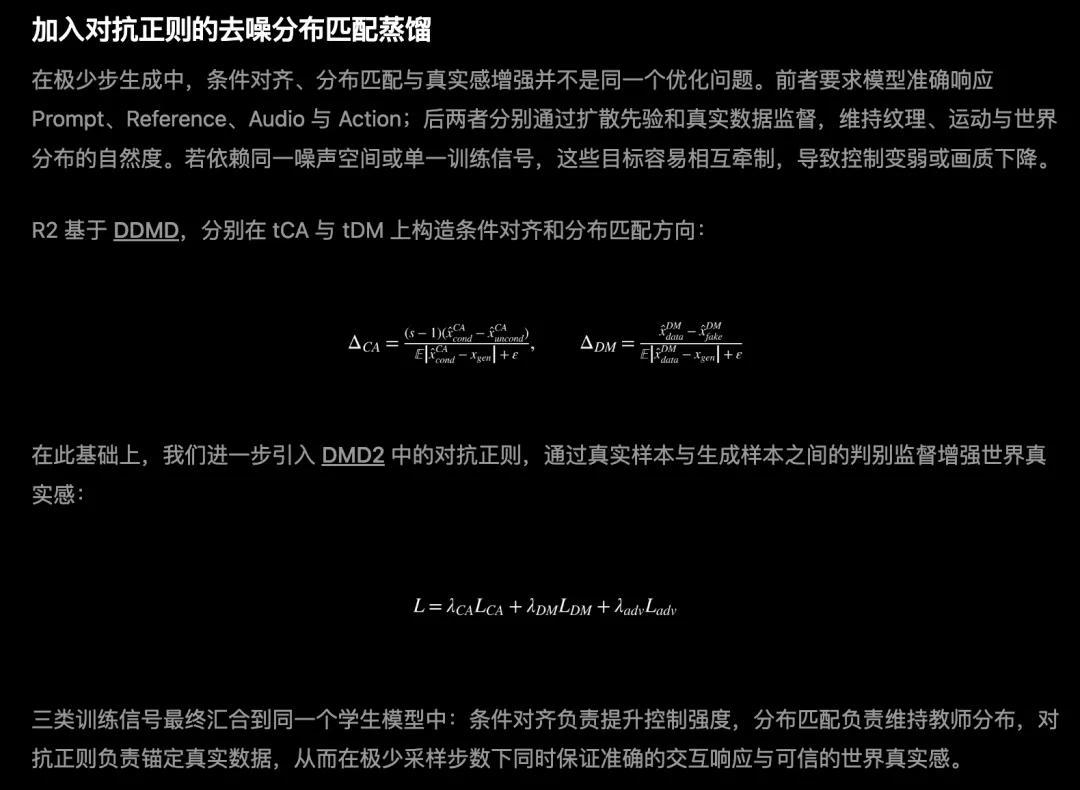
R2不僅在模型內部省錢,還在產品層面做到了開箱即用。據瞭解,R2 的最新版本已經把AI知識庫、語音都集成進了模型內部,真正做到音畫同步輸出,廠商只需要接一個API,就能用到完整的模型能力,不用額外付費或外掛能力。
當然,目前R2只公開了幾段幾十秒的演示Demo和技術報告,他們自己也在報告裏承認,R2的生成質量距離前沿的離線視頻模型還有差距,模型仍處於預訓練研究階段。
也就是說,雖然他們摸索出了一條比較明確的路線和框架,但上限在哪,還需要持續驗證。
02
給遊戲行業開了個口子
雖說挑戰還有不少,但到了這個階段,世界模型能討論和想象的空間已經大多了,對遊戲行業的影響也更清晰了。
其中最先可能發生的影響,是一些遊戲品類可能會有新變化。
比如互動影遊類產品。自從《完蛋!我被美女包圍了!》爆火,這個品類煥發了第二春,但最大的挑戰一直是成本。不管真人實拍還是AI生成視頻,都要先做出數十上百小時的內容,遊戲還沒見着玩家,錢就先花出去了。
而世界模型實時生成內容,相當於後置了很多成本,回收風險更低。至於大家擔心的生成質量,我認爲類比AI短劇的發展趨勢,後續會有一批人能接受這種明知是AI,但還是想圖一爽的內容,R2也許能正好卡在這個需求上。
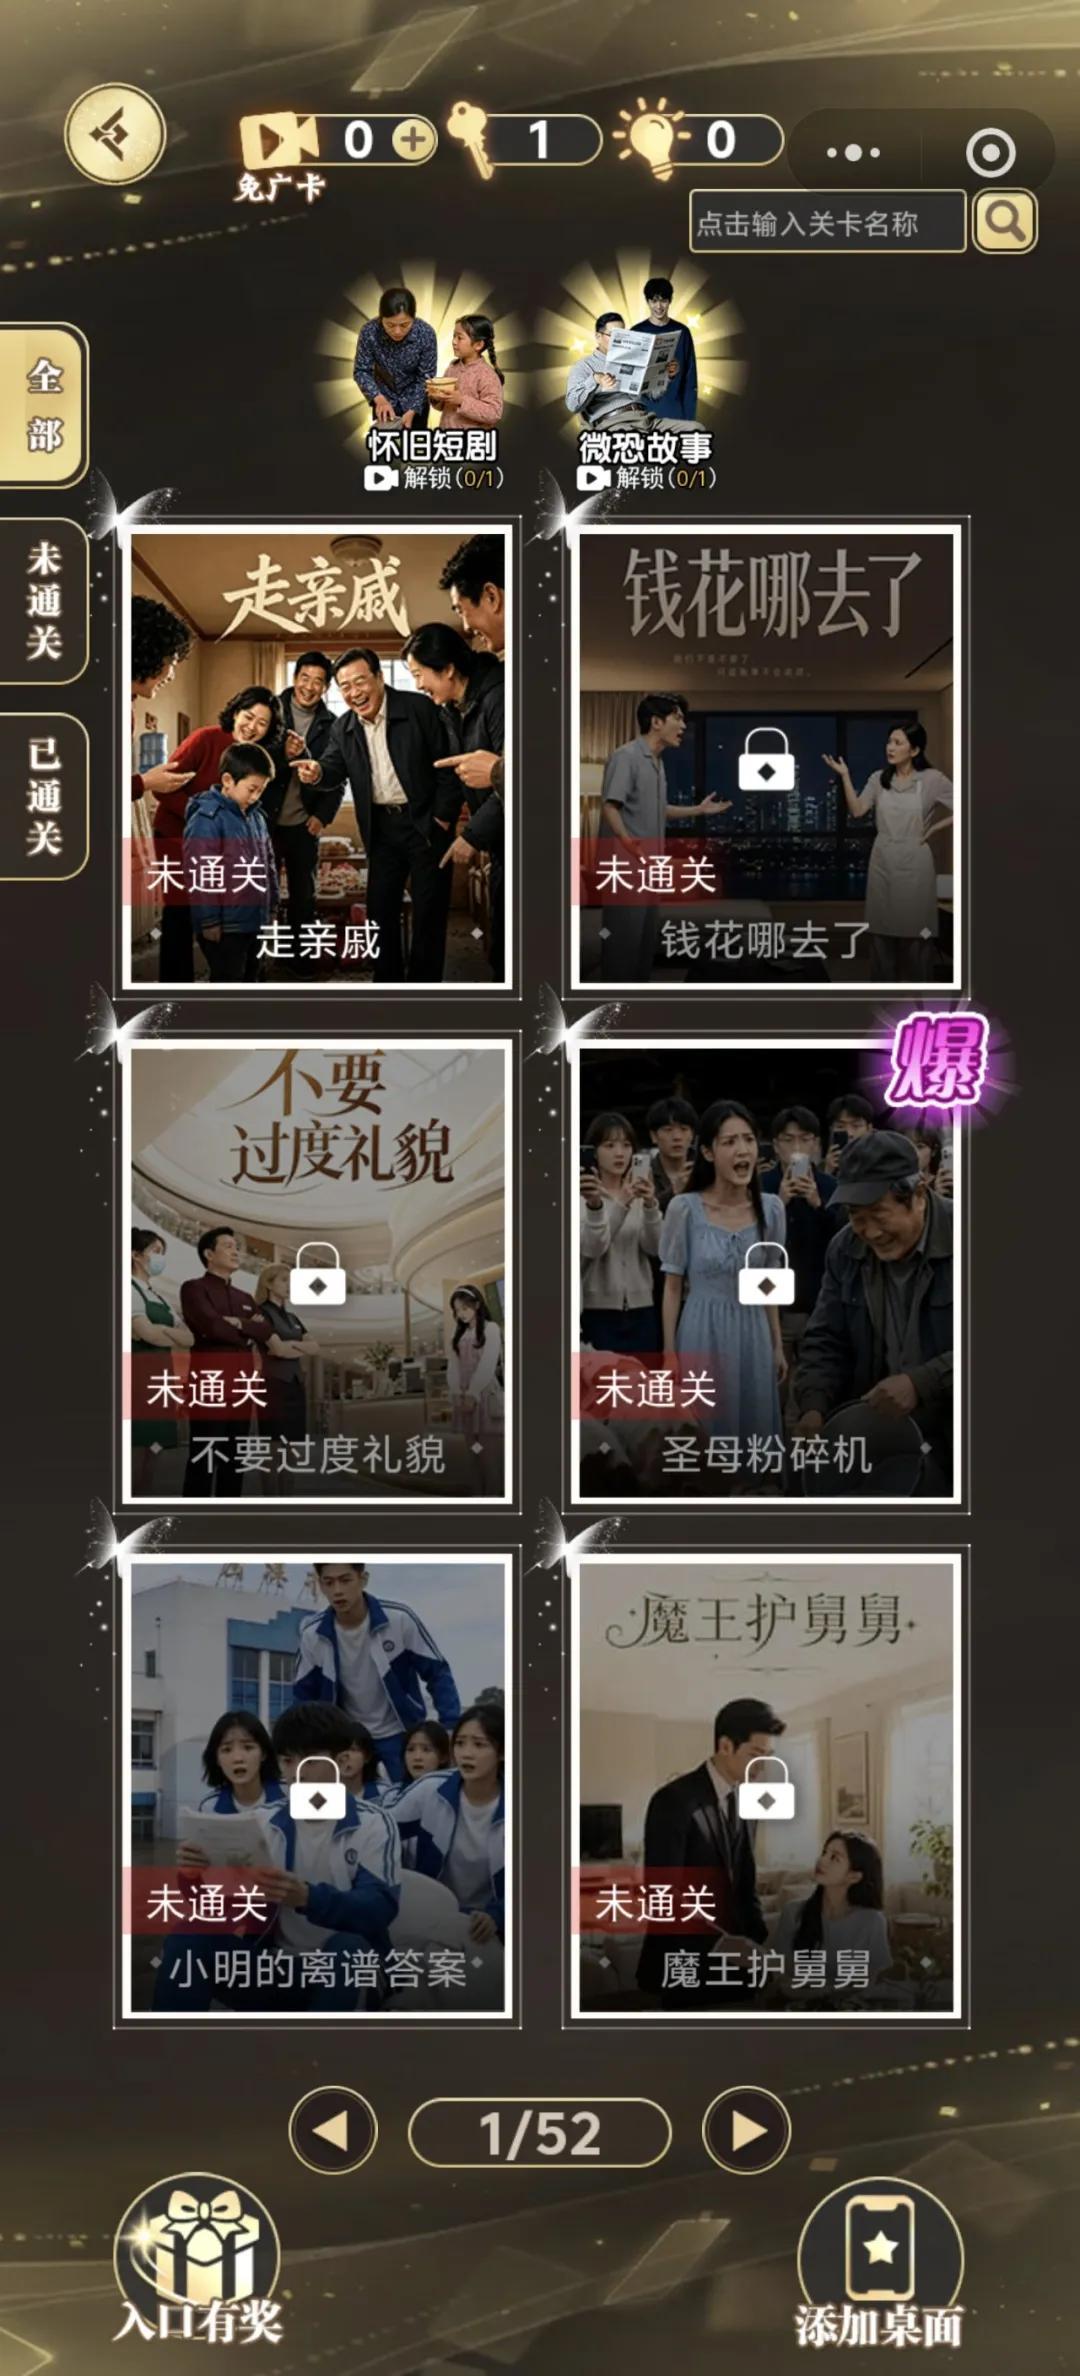
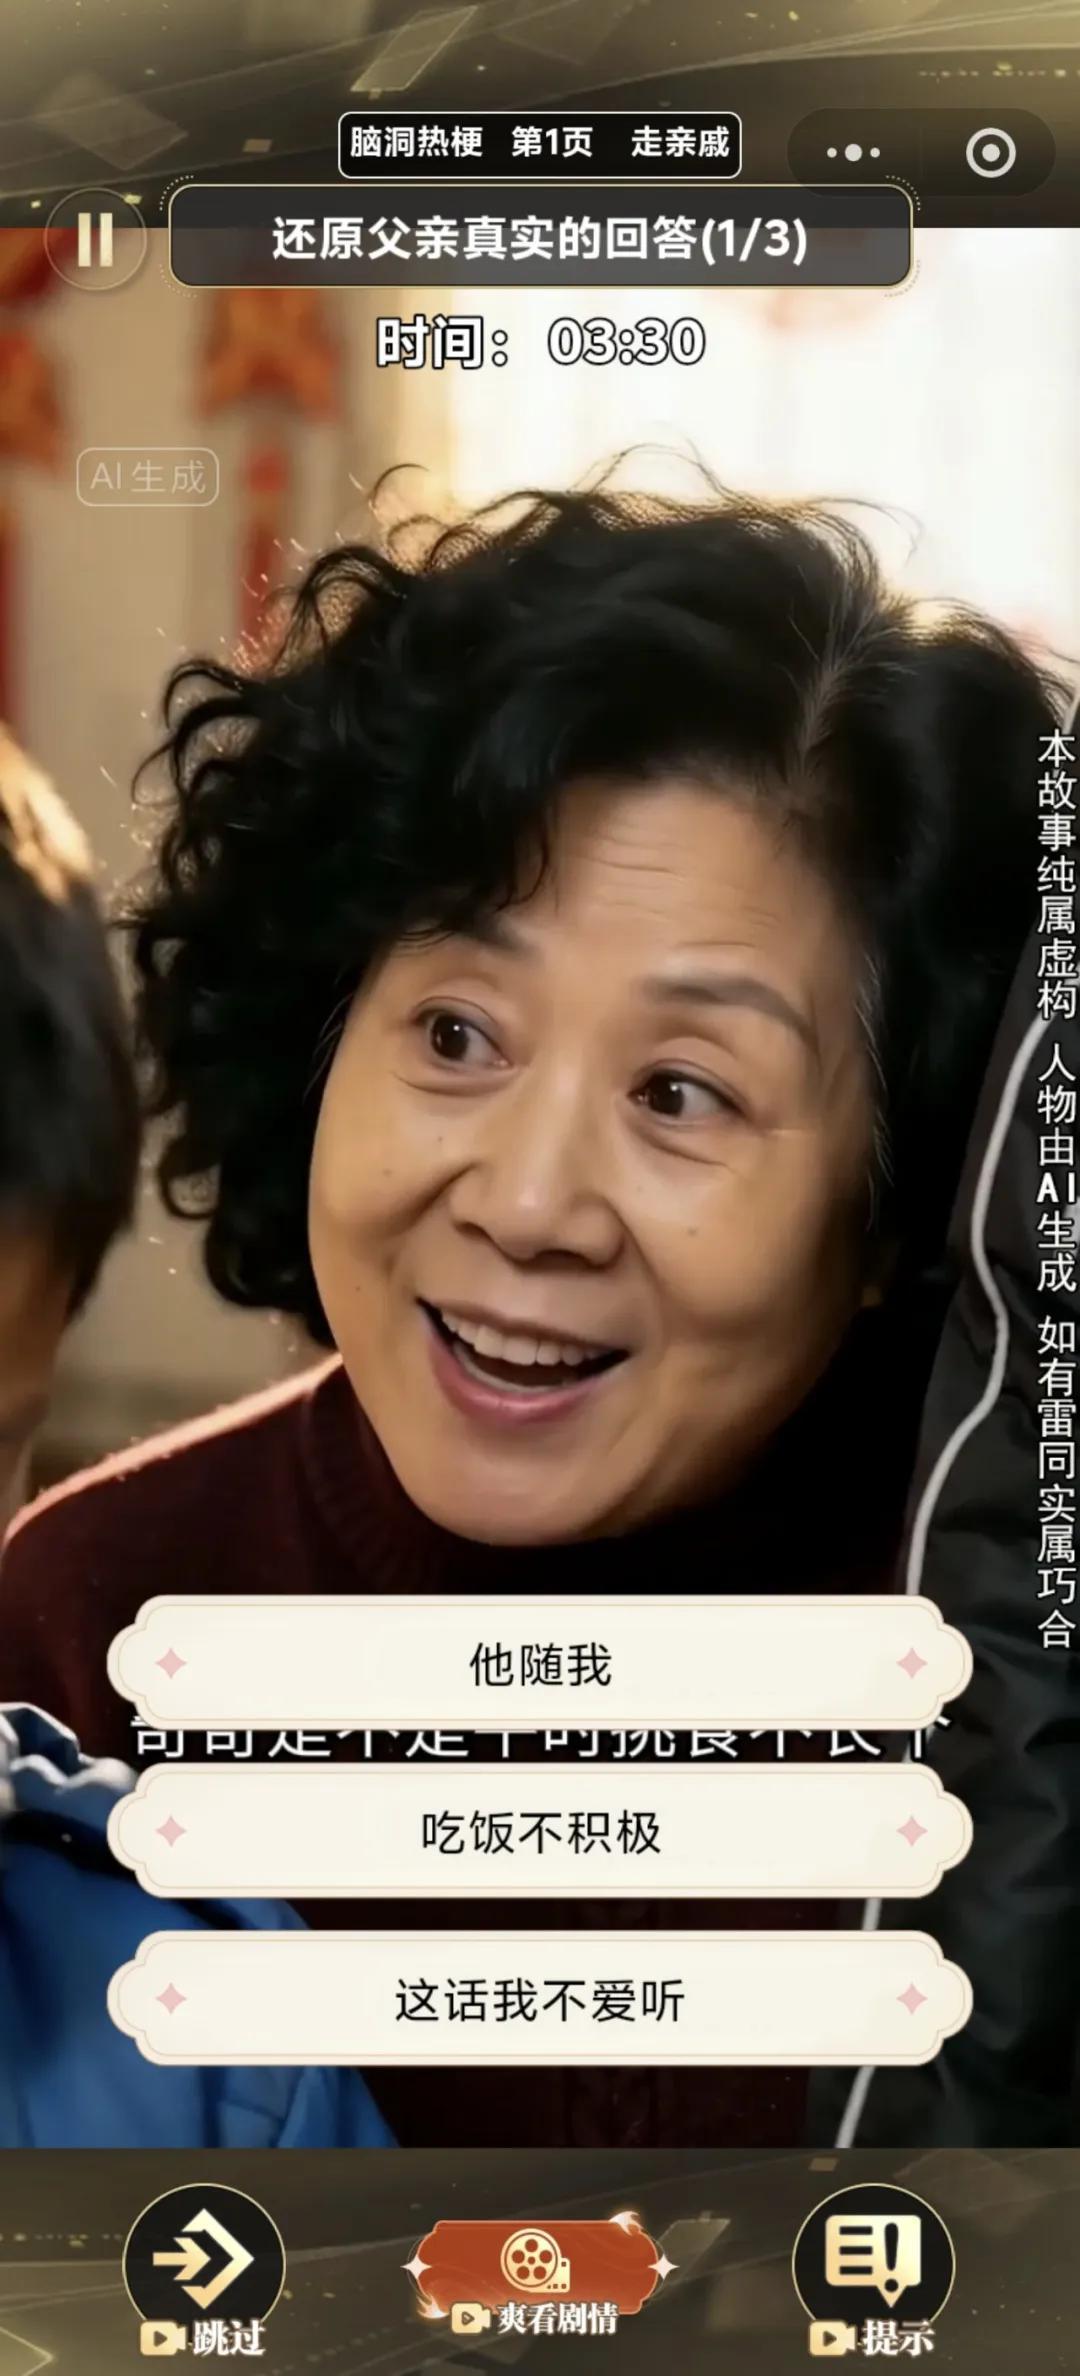
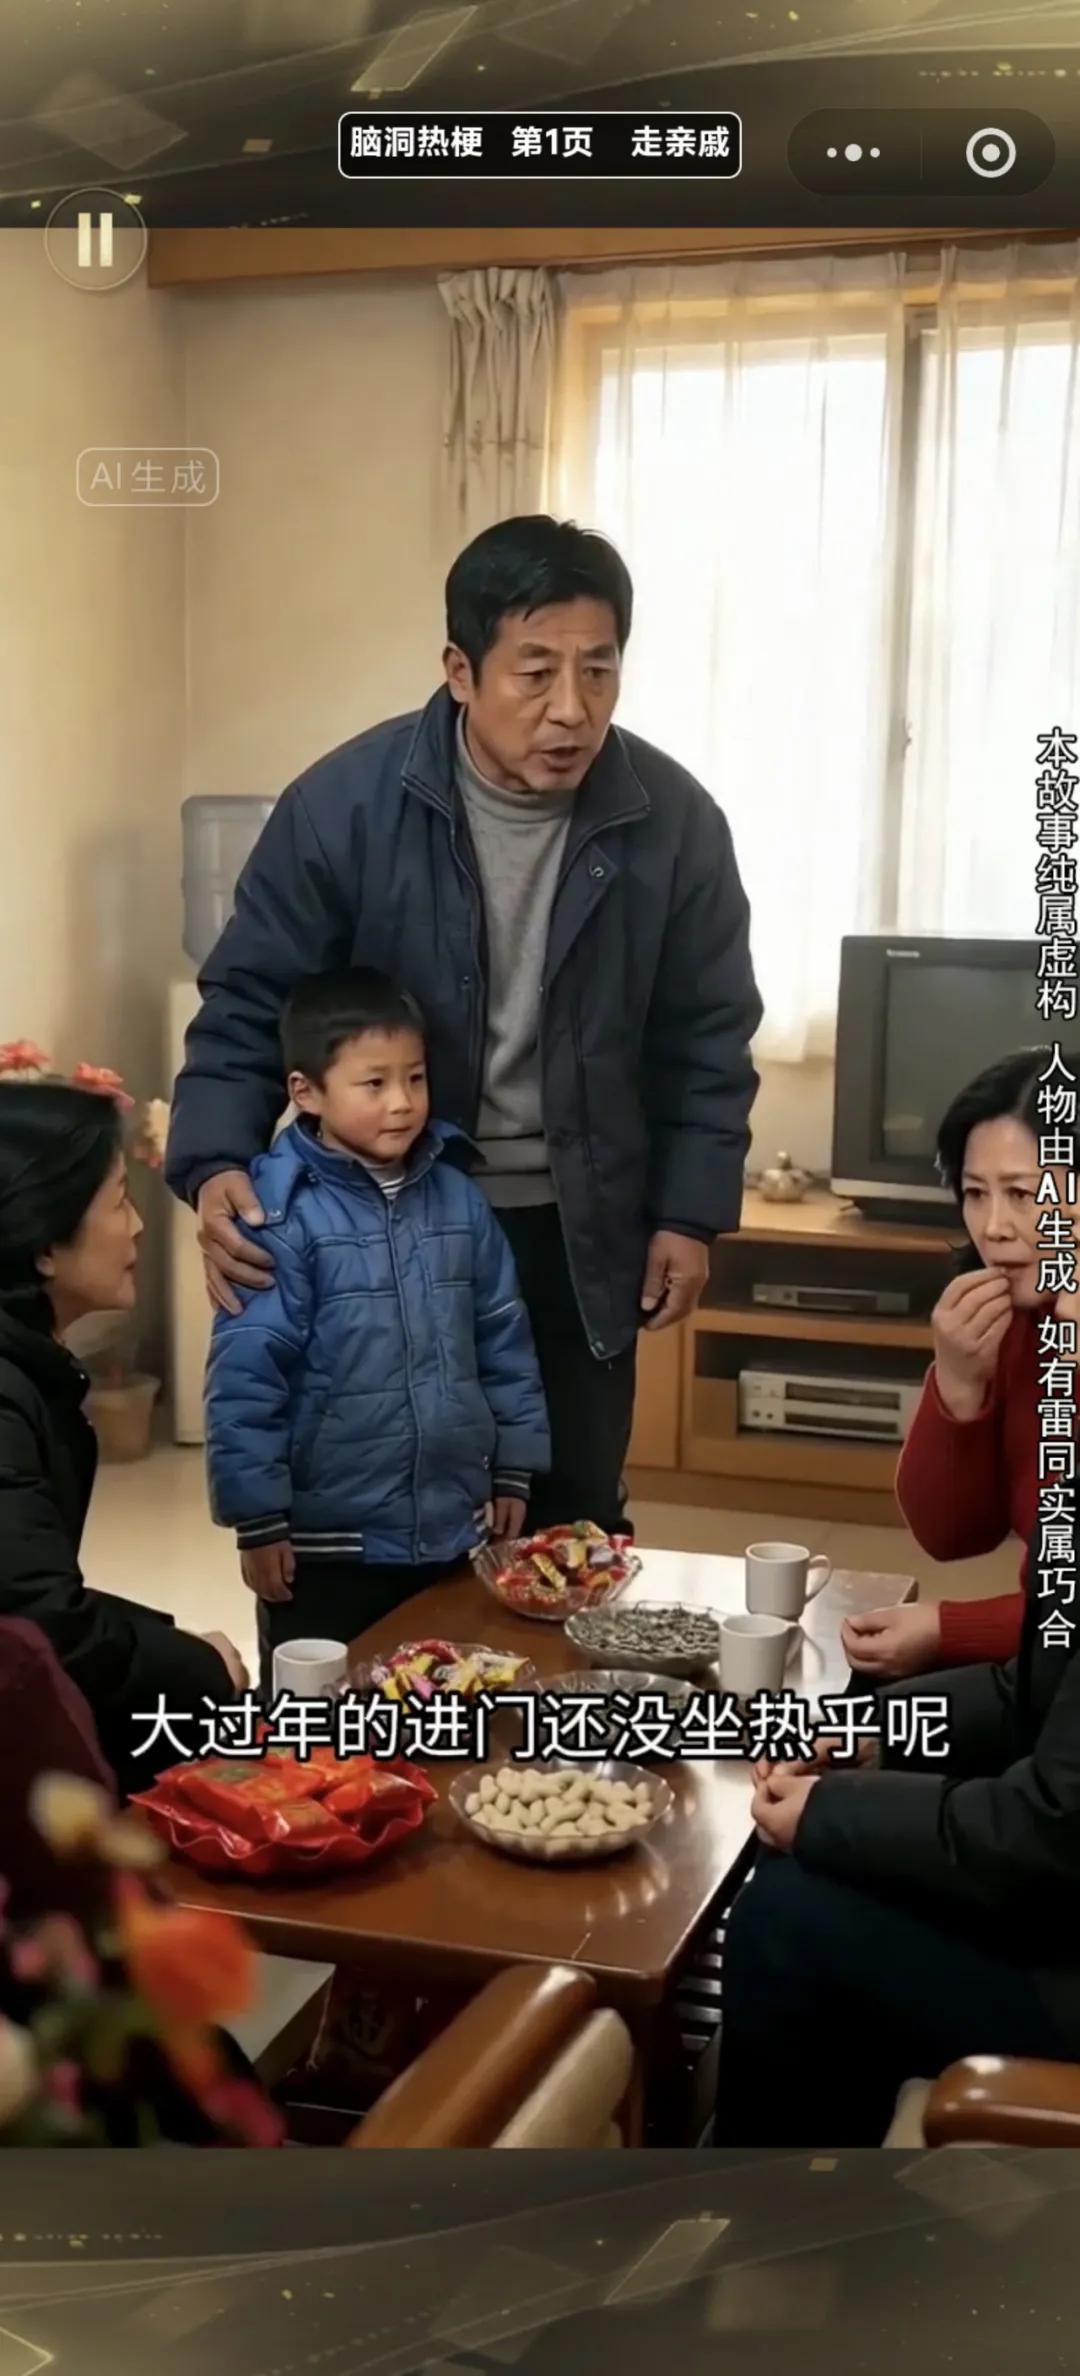
比如近期爆火的互動影遊小遊戲《別崩人設啊》
可點擊查看大圖
有意思的是,今天PixVerse官方還公佈了三段基於R2世界模型的互動影遊Demo,除了上面導演小籠包的作品《Zero Mark》外,還有導演JadeWu的科幻恐怖題材作品《畸變回聲》;
以及導演也毛的科幻太空探索作品《Battle of the Moon》,在有導演的精細監製下,R2的生成質量顯然高出了很多。
再比如情感陪伴類遊戲。前面說過,R2生成的角色一致性高、交互自然,比起3D/2D建模加動作庫的傳統路線,在成本、流暢度、交互體驗上都有優勢。未來的二次元、女性向產品,或許真能用上這個技術。目前愛詩內部孵化的兩款項目已經在嘗試應用,還有一批潛在合作伙伴正在接觸。
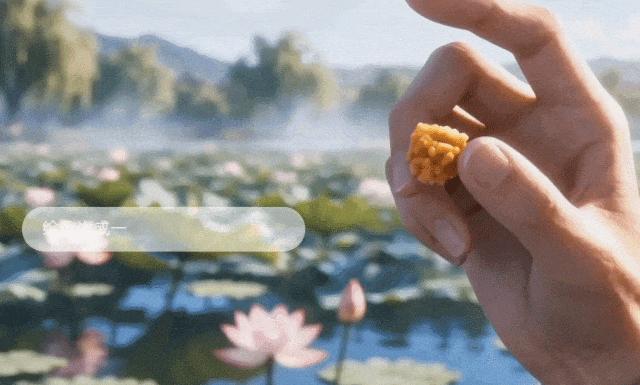
愛詩孵化的乙遊項目的PV畫面
稍遠一點的影響,是遊戲研發。
世界模型的流程是從文字直接跨到可交互的「遊戲」。這意味着開發者腦子裏的東西能更快落地。比如策劃直接用文字預覽遊戲Demo,讓玩法創意、畫面機制用更具體的方式呈現。甚至更進一步,遊戲研發這件事,能不能靠世界模型實現邊做邊測?
再往遠處說,創造和體驗的邊界可能會被進一步模糊。
比如玩家的娛樂方式,變成了隨時隨地創造出世界;或者未來遊戲對抗的形態從規則變成想象力,你能掏出飛機大炮,我能修仙鬥法……
再比如UGC會不會成爲一個更普遍的現象?畢竟《我的世界》將編程語言變成方塊,就撐起了這麼大的創作生態,那直接用自然語言造世界,潛力會不會更大?
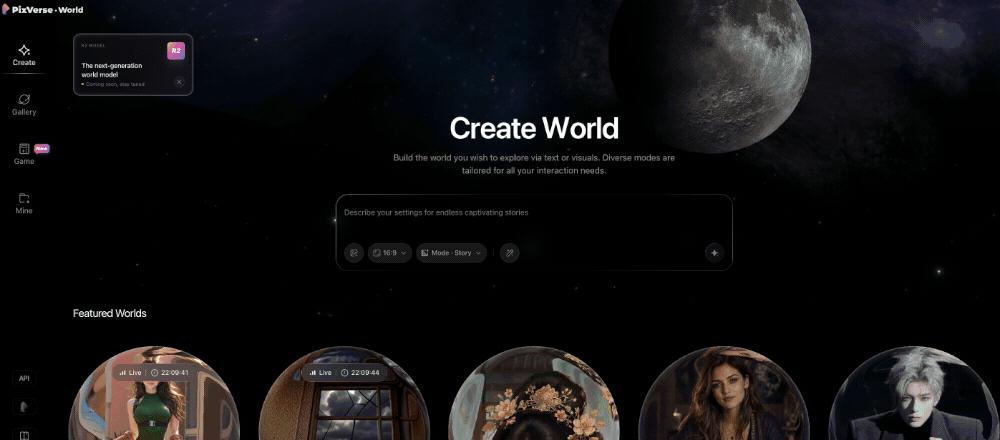
R1目前可以輸入幾個字,等待30秒後,生成一個可持續運行5分鐘的世界,創作門檻極低
當然,上面這些內容更多隻是未來暢想。而且我猜聊到這裏,有的朋友又要問那個問題了:世界模型會跟遊戲行業競爭嗎?
我對此傾向於樂觀。
首先,世界模型更像全新的娛樂形態,仍處於萌芽期。畫面和玩法在很長時間內都趕不上主流遊戲。有從業者表示,他們的世界模型產品跟《荒野大鏢客2》比,可能連萬分之一都做不到。
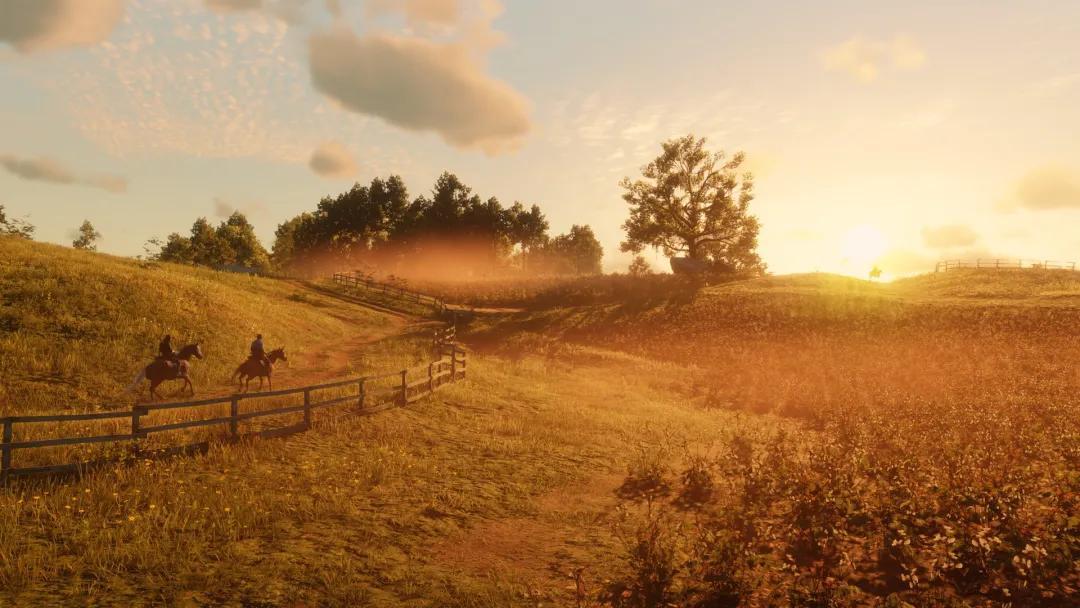
其次,兩者的體驗存在一定錯位。大家玩遊戲,更多玩的是創作者的獨特表達,美術、玩法、敘事等都是收束的;而目前來玩世界模型的人,有不少玩的是隨機體驗、控制慾、想象力,反而模型生成得越離譜越好。玩家上號玩精品遊戲,閒下來再隨手造個世界,兩件事並不衝突。
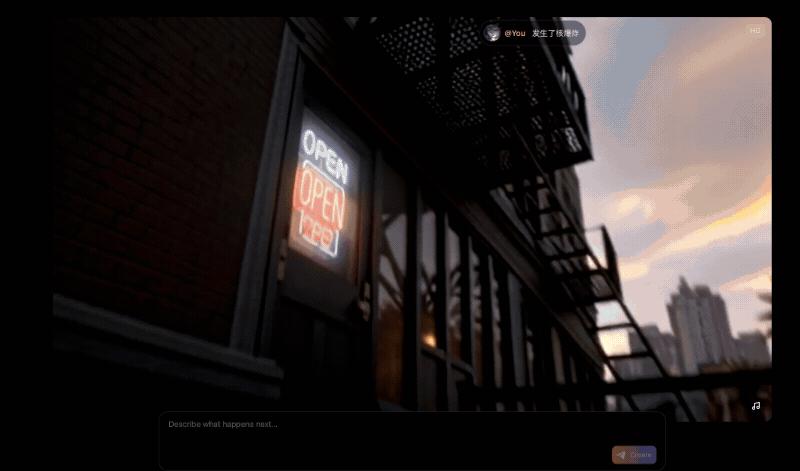
R1世界模型,輸入核爆炸、飆車、喫飯(動圖有剪輯)
最後,兩者有互補的趨勢。遊戲行業一直在追求GaaS化和無限遊戲,需要源源不斷的內容留住玩家,而世界模型等AI技術,是能持續提供內容的主流手段;反過來,世界模型需要海量數據和規則去收束訓練,遊戲又是採集數據、驗證成果最好的場所之一。
其實回頭看,「遊戲」這個詞的邊界一直在變化。從線下娛樂到遊戲機、單機、端遊、手遊……每一次技術突破,都讓遊戲的形態擴容一次。
而這一次,站在邊界上的是世界模型——它未必會長成我們所熟悉的遊戲的樣子,但它構建的世界、帶來的體驗,很可能會在下一輪擴容中扮演重要角色。