我和我的 AI 手機喫了 3 頓飯
米其林三星餐廳潮上潮有一個特別的就餐模式「潮 1/2」:在餐廳後廚旁邊放一張小餐桌,供少數人就餐,飯菜在主廚做好的瞬間即可上桌,最大程度地減少傳菜過程中的風味和熱量損耗,呈現出最好的味道。
對於講究「一熱頂三鮮」的中國人來說,這個就餐模式自有親切感。
理解了這個,就可以理解高通推出的高帶寬計算技術(High bandwidth compute,HBC)了。
把計算放到內存旁邊,就像把飯桌放到廚房旁邊去
當 ChatGPT 在屏幕上一個字一個字往外吐提問的答案時,我們會很自然地把速度歸因於「計算」:CPU 更快一點、GPU 更強一點、NPU 多幾十 TOPS,AI 應該就能回答得更快。
但實際情況不是這個樣子的。
在 PC 時代,我們習慣看 CPU 的主頻;智能手機剛興起的時候,每個廠商都參與了「核戰爭」,比拼誰選的處理器核心數更多;後來遊戲成爲旗艦手機的重要戰場,以及整個鏈條的重要收入來源,於是 GPU 性能和移動光追等指標開始備受關注。
計算性能就像汽車發動機的馬力,數字越大,似乎總不會錯。但是,AI 運行的時候,芯片裏的 CPU、GPU 和 NPU 往往沒有在全速工作。
它在等。等數據從內存裏送過來。
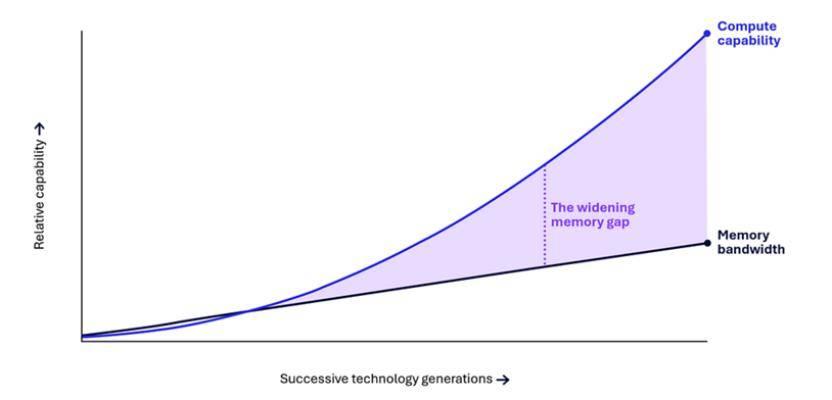
過去十年裏,AI 計算能力和模型規模快速膨脹,但內存容量、帶寬和數據搬運效率並沒有以相同速度增長。最終,越來越多的時間和能耗花在數據移動上,而非真正的計算。
這就是「內存牆」,大語言模型因爲這個「大」字,開始撞牆了。
一次生成式 AI 推理,大致可以分成兩個階段。第一階段叫是Prefill,可以理解爲「讀題」。
用戶給 AI 一份幾十頁的 PDF,或者告訴它「幫我總結過去一年和你的聊天記錄」,模型首先需要把大量輸入內容讀進去。這部分工作會進行大量矩陣運算,所以計算能力依然非常重要。
到了第二階段 Decode 的「答題」階段,工作性質發生了變化。模型每生成一個 token,都需要不斷讀取模型參數以及之前累積下來的上下文,但實際進行的計算相對有限。
這就跟去餐廳喫飯一樣,後廚的廚師已經炒好了 10 個菜,但是傳菜員只有 1 個,那麼從廚房(內存)到餐桌(計算)一次也就上一兩個菜,根本不夠喫。
問題的關鍵就是找到關鍵的問題:不是廚師不夠,而是傳菜員太少。
既然找到了關鍵的問題,那麼產業就可以着手解決問題了,也誕生了不少方法。
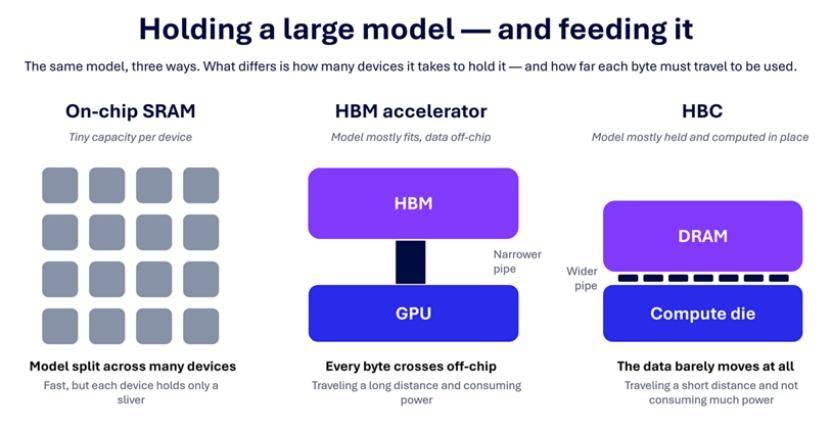
有一種技術路線是 SRAM(Static Random-Access Memory,靜態隨機存取存儲器)就像是板前料理,把廚房搬到餐桌前,飯菜做好了就能端到食客面前。但是喫過板前料理的人也清楚,這種就餐模式菜單固定,並且價格一般還很貴。剛好,SRAM 的單位面積成本很高,很難用有限芯片面積裝下越來越大的 AI 模型。
HBM(High Bandwidth Memory,高帶寬內存)就像是壽司郎,後廚很大,就餐區也很大,後廚和就餐區之間有類似於「高速列車」一樣的傳送帶,嗖嗖嗖地上菜。壽司郎的情況大家也看到了,排隊極其誇張,想喫好也不算便宜,同理,先進 HBM 依賴複雜的堆疊和封裝技術,成本高,供不應求。
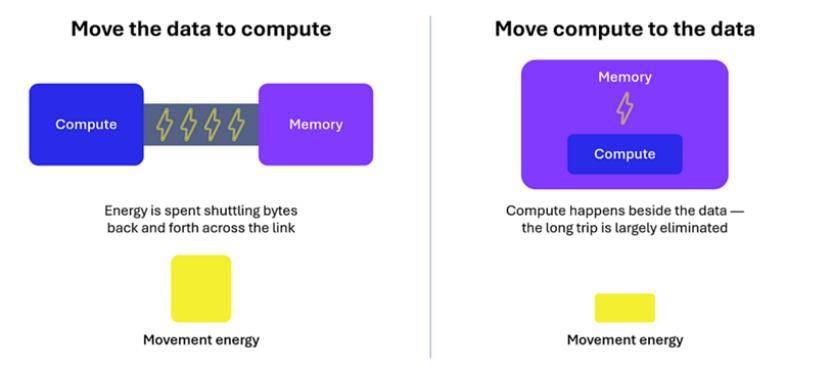
高通推出的高帶寬計算技術(High bandwidth compute,HBC)是一種近內存計算架構思路,也就是前面說的「潮 1/2」,把餐桌(計算)搬到廚房(內存)那裏去,減少數據和計算之間的搬運,從而加速 AI,減少功耗。
這其實和這麼多年計算機產業的思考方向相悖的,過去是處理器越來越強,數據不斷向處理器集中,但 AI 的發展迫使大家重新思考。當然,HBC 並不意味着以後所有計算都會跑進內存,Prefill (預填充)這樣的高計算強度任務,依然需要強大的計算單元;遊戲、視頻編輯、影像處理同樣不會消失。
大模型裏的矩陣乘、向量運算、Embedding 查詢、部分 Attention / KV Cache 相關操作,往往要讀取大量數據,這些計算適合應用在 HBC 這裏,也就是「數據搬運成本很高的計算」;CPU / GPU / NPU 依然負責「計算本身更復雜的任務」。
這本身也是一種異構分工。
HBC 技術雖然發佈了,但商用還得一點時間,但針對 AI 對計算的新要求,以及舊需求舊模式依然很重要的情況,「異構分工」成爲了一種核心的解題思路。
尤其是 AI 智能體手機這種新物種。
把 AI 計算放在最適合計算 AI 的地方去
如果手機只負責運行一個聊天機器人,事情其實會簡單很多,做一顆巨大的 NPU,把模型塞進去,讓它儘可能快地生成 token。
但要消費者接受的 AI 智能體手機顯然複雜得多,它需要理解用戶的個人情境,在多個應用之間運行,持續推理,並根據用戶意圖採取行動。未來更可能出現的,也不是一個龐大的模型包辦所有事情,而是多個專用模型根據任務、情境和用戶需求動態協作。
用戶對手機說:
我晚上 7 點和朋友喫飯,幫我看看從公司過去會不會堵車,如果下雨就幫我叫車。順便看看這家店有什麼招牌菜,把朋友上次說不能喫的東西排除掉。
這句話背後可能發生一連串動作:識別語音;理解意圖;讀取日曆;尋找餐廳信息;讀取歷史聊天上下文;調用地圖;判斷天氣;必要時訪問雲端 API;最終再把結果呈現給用戶。
其中既有大模型推理,也有操作系統調度、應用調用、網絡通信、視覺和語音模型。
如果手機正在導航、錄像或者運行遊戲等等任務,事情還會更加複雜一些。所以 AI 智能體時代的芯片,並不會突然拋棄過去幾十年建立起來的 CPU、GPU、NPU 分工。但是,CPU、GPU、NPU、緩存、內存乃至傳感器中樞,都需要開始圍繞 Agent 重新安排自己的位置。
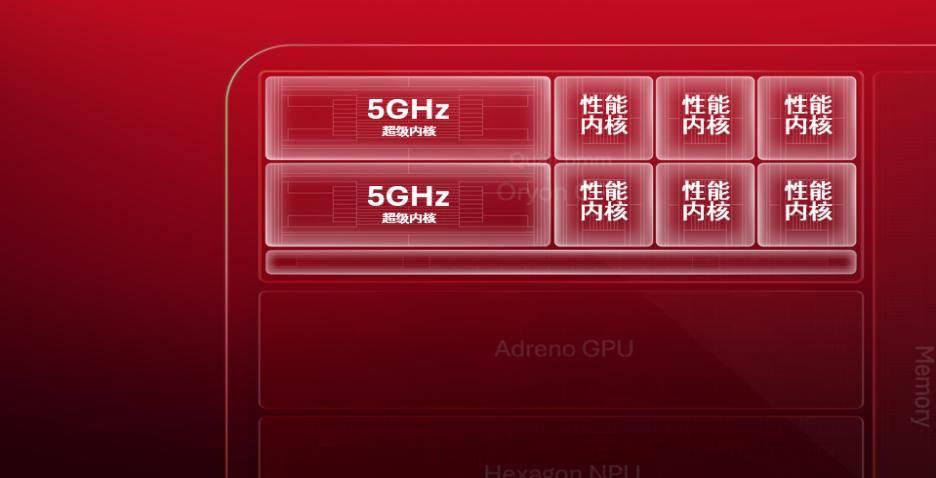
即將發佈的下一代驍龍旗艦的 Qualcomm Oryon CPU 有適合放到標題裏的的數字:5GHz,這是首個最高主頻達到 5GHz 的移動 CPU,高通稱之爲全球最快的移動CPU。
如果放在十年前的「核戰爭」時期,這絕對是媒體報道的焦點,但今天,還有另一個搶戲的技術:Qualcomm Oryon FlexCache 可擴展緩存架構。
它讓不同類型的核心可以共享一個緩存池,並根據任務動態獲得更多空間。當超級內核突然面對重負載時,它可以使用更大的緩存;當任務在線程之間遷移時,相關數據也能繼續留在緩存裏,無需重新跑一趟系統內存。
爲什麼需要這個技術呢?
這是因爲 AI 智能體的工作方式天然就是「跳來跳去」。智能體任務會先理解問題,再調用一個工具;工具返回結果之後,再規劃下一步;隨後可能切換另一個應用或者模型。
5GHz 和 FlexCache 其實是一體兩面:前者讓智能體任務跳得更快,後者讓智能體任務跳得更輕鬆。
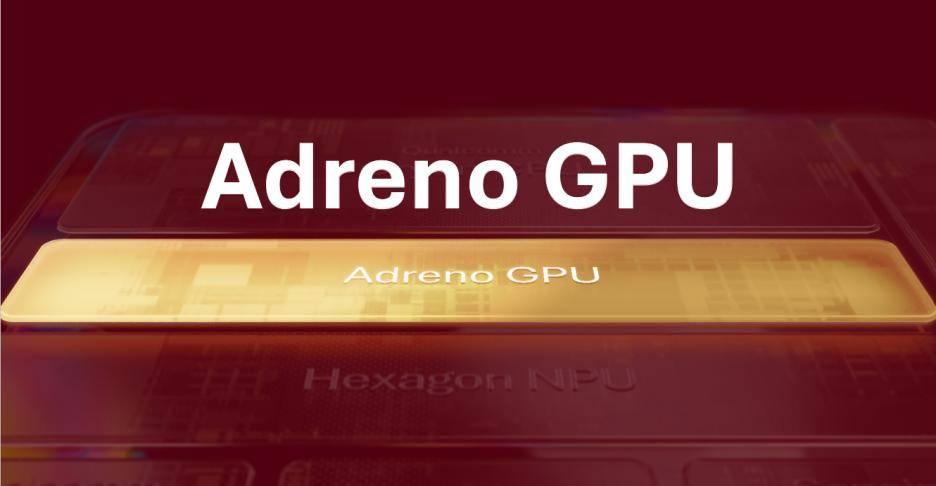
類似的,下一代 Adreno GPU 則直接加入了專門面向 AI 計算的 Adreno Matrix Cores(矩陣計算核心),就是集成在 Adreno GPU 內部、專門負責 AI/矩陣計算的硬件加速核心。
過去幾年,AI 在手機 GPU 中扮演的角色越來越重要,超分辨率、幀生成、降噪,很多過去依賴傳統圖形算法完成的事情,開始交給神經網絡。高通同時推出 Adreno Neural Fusion 神經網絡融合渲染技術,可以把神經網絡處理、AI 超級分辨率和 AI 幀生成統一到圖形管線中。
DLSS、FSR 之類 PC 端顯卡技術已經證明了每一個像素並不一定都需要傳統圖形管線「老老實實」算出來,其中一部分可以由 AI 猜出來。
傳統方法想讓遊戲從 60 幀變成 120 幀,往往意味着 GPU 得幹接近翻倍的活。但是 AI 幀生成提供了另一種選擇:有些幀可以「生成」。
但 AI 進入圖形管線之後,又產生了新的問題,神經網絡計算需要數據。如果這些數據依然在 GPU、NPU、系統內存之間來回穿梭,省下來的計算可能又被搬運喫掉。
於是高通又在 GPU 旁邊放了一塊 18MB Adreno 獨立高速顯存 HPM,它可以存放渲染目標、顏色緩衝、深度緩衝、紋理以及中間結果,讓更多圖形和 AI 數據停留在 GPU 內部。
覺得聽起來有點複雜?沒關係,因爲它還是熟悉的思路:讓飯桌離廚房近一點。
說完 CPU 和 GPU,到了 Hexagon NPU 部分,這種思維模式轉變就更加徹底。
下一代 Hexagon NPU 新增了 Element Accelerator,它專門針對 Transformer 工作負載設計;同時擴大共享內存,讓更多模型狀態、上下文以及 KV-cache 保留在靠近加速器的位置。
這裏的 KV-cache 可以簡單理解成 AI 的「工作記憶」。用戶和 AI 聊得越久,它需要記住的上下文越多,這部分數據也就越來越大。如果每生成一個 token,都要跑到遠處重新翻一遍聊天記錄,速度自然會越來越慢。
你懂的,還是把飯桌搬到廚房旁邊,在新一代 Hexagon NPU 上,大容量共享內存最高擴容 50%,目的就是減少訪問 DDR 內存的次數。
與此同時,高通還和模型廠商合作,引入了混合專家模型(Mixture-of-Experts,MoE)構建新一代終端側 AI 架構。這種靈活架構可以讓一個 30B 的 MoE 模型在保持數百億參數可用的同時,在 NPU 上每次生成一個詞元僅需激活約 30 億個被路由選中的參數,這種動態選擇機制就可以減少實際計算負載和內存帶寬需求。
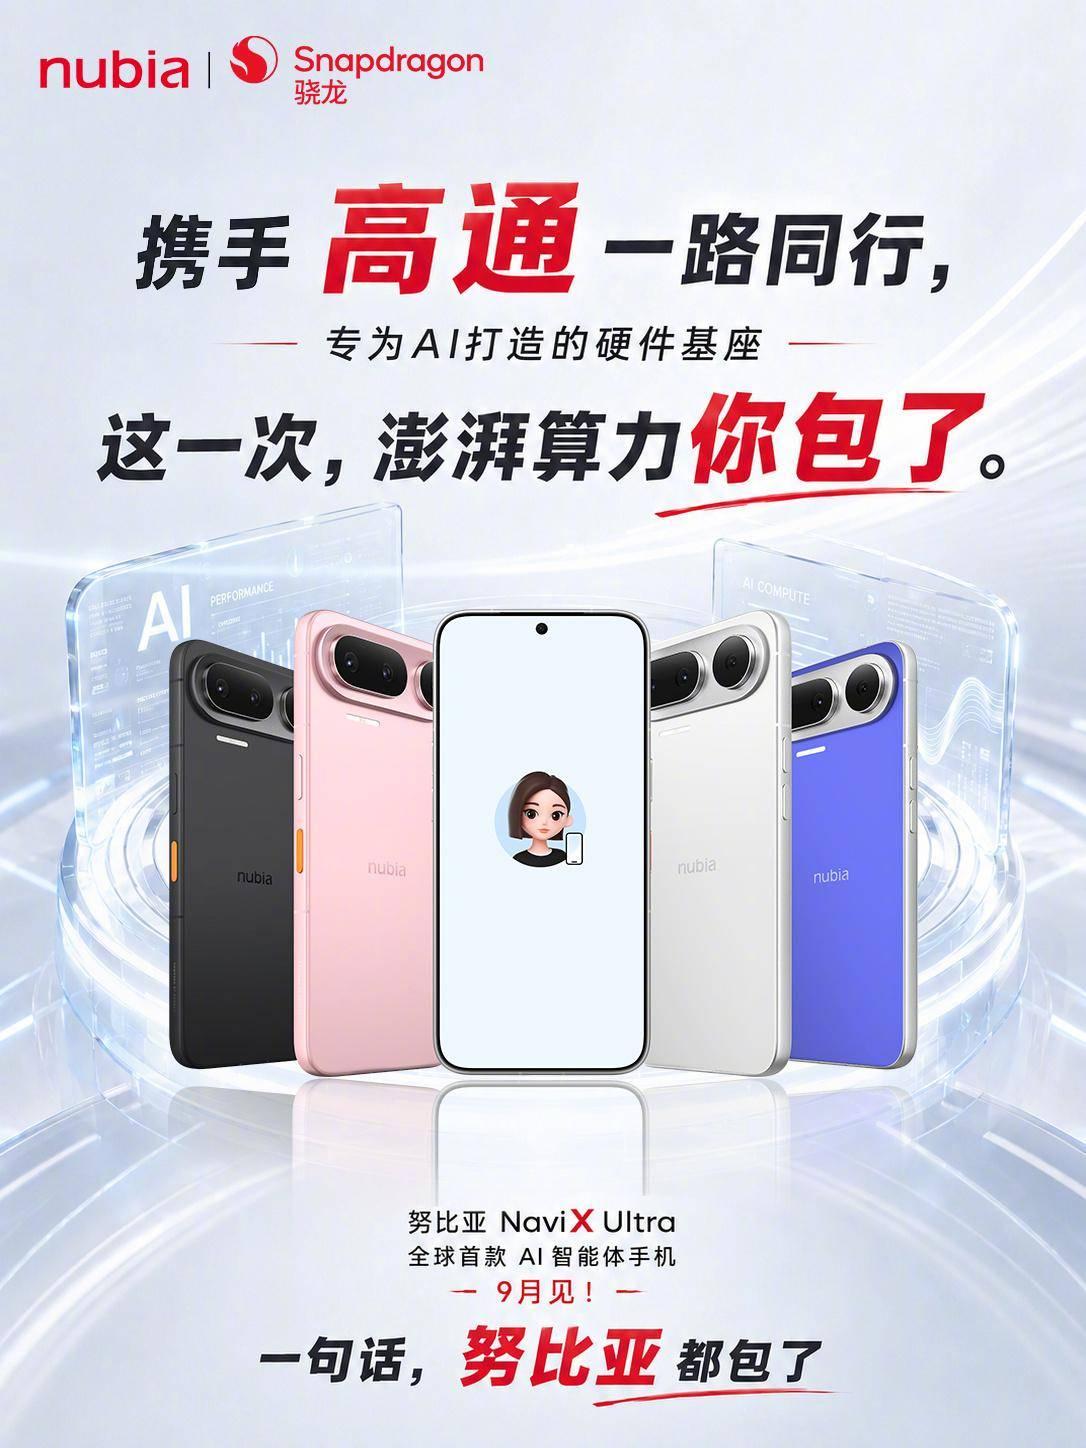
努比亞 Navi X Ultra AI 智能體手機,搭載高通芯片
AI 智能體手機就要來了,高通想要承前啓後
智能手機發展到今天,其實已經很難找到真正獨立工作的芯片模塊了。按下快門的一瞬間,CPU、ISP、GPU、NPU 都可能參與其中。
遊戲也是如此。CPU 負責遊戲邏輯,GPU 渲染畫面,AI 可以負責超分、幀生成,調制解調器還要維持網絡連接。
AI 智能體只是讓這種協作更進一步,Sensing Hub 會保持低功耗的環境感知;Oryon CPU 則像一個領班負責規劃、推理和編排工作流,決定什麼時候調用工具、什麼時候訪問雲端;Hexagon NPU 承擔主要的高效端側 AI 推理;Adreno GPU 則可以參與多模型推理,同時繼續完成圖形任務。
技術發展的歷史往往就是這樣,今天那些已經理所當然的體驗,最早都曾經是一串無人關心的技術名詞。
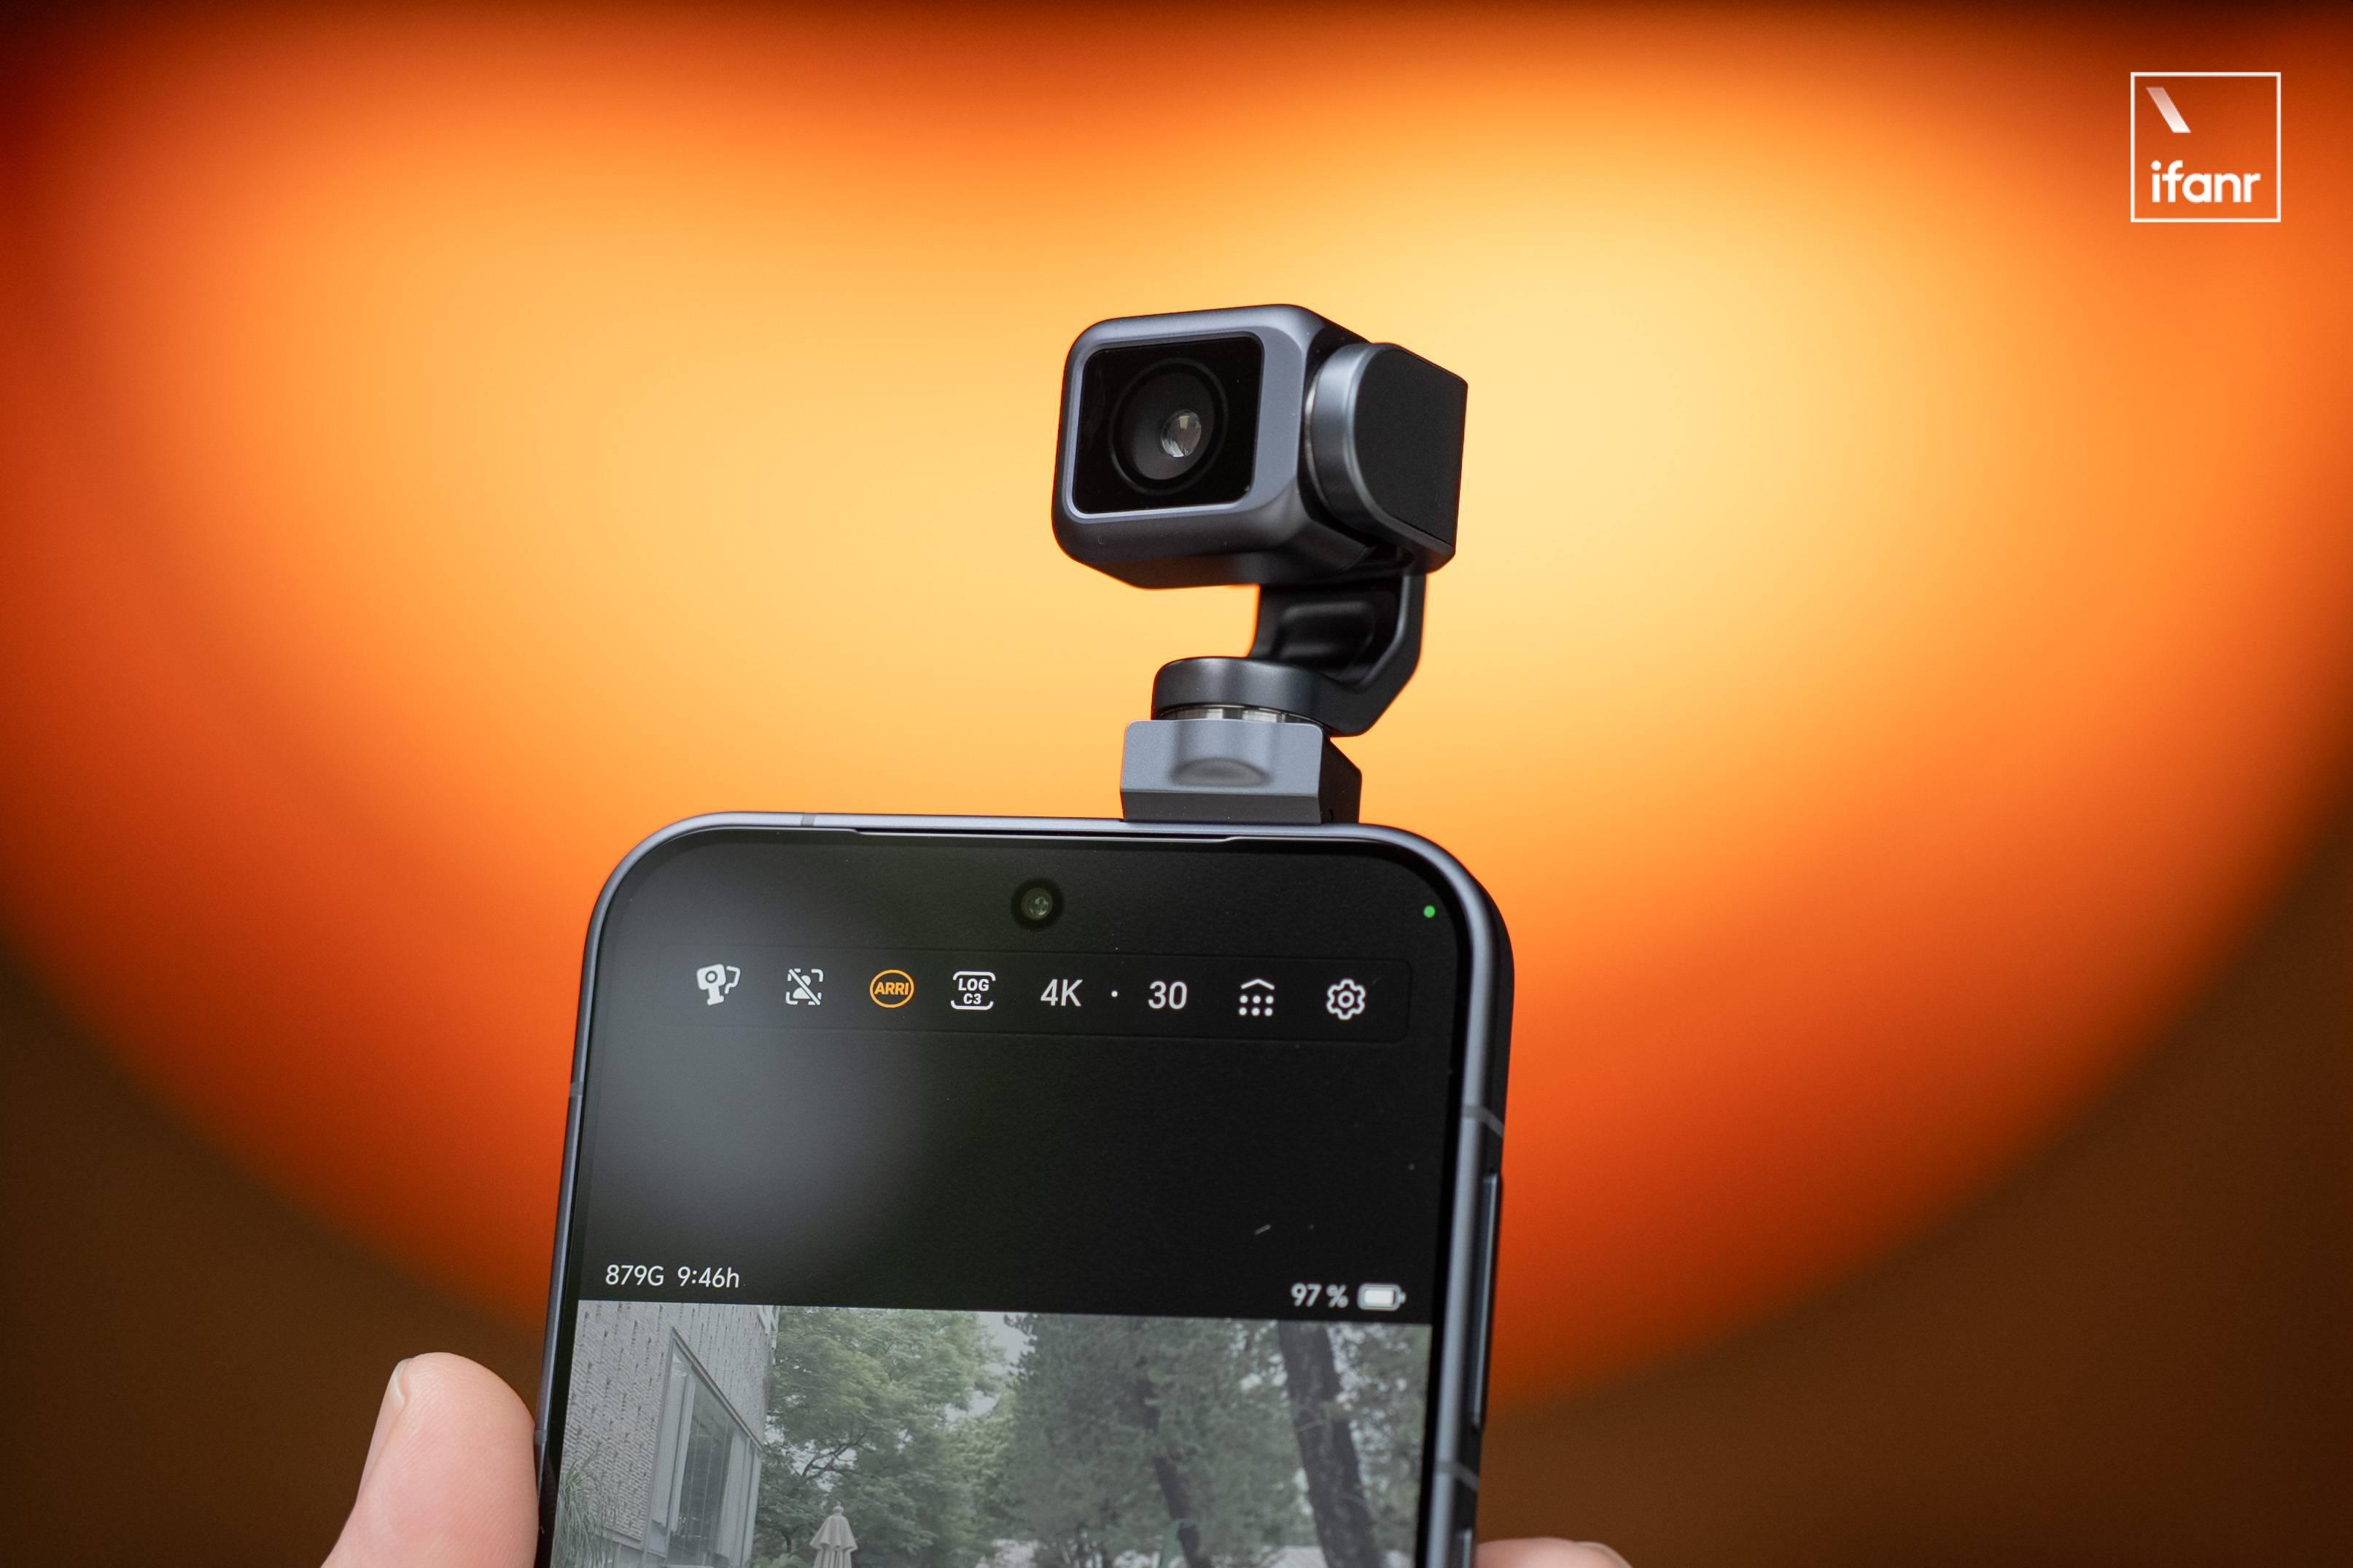
榮耀 Robot Phone
十幾年前,手機廠商第一次開始認真討論 ISP 時,大多數消費者並不知道 ISP 是什麼,後來我們有了「影像旗艦」。
同樣的,當時的人們也很難想象一部小小的手機,可以玩主機級的遊戲大作,但現在的 GPU 能力支持這麼做。
所以高通對於 AI 手機的意義,也許就在這裏。即將紛至沓來的 AI 智能體手機,不會在包裝盒上寫着「採用更大的 KV-cache」,就像影像旗艦也不會在包裝盒正面寫着 ISP 架構。
用戶最終感受到的,只會是:手機更懂你;一句話能完成更多事情。
發生在 CPU、GPU、NPU 和內存之間的複雜調度,最終都會被隱藏起來。就像坐在「潮 1/2」裏的客人,不需要知道一道菜從櫥櫃到案板究竟經過幾米。
他們只知道這道菜上來的時候,一切剛剛好。
過去很多年,高通參與定義了手機的影像能力、遊戲能力和連接能力。現在,這家名字意思是「高質量連接」的公司開始思考如何更好地連接起 AI 和計算,開始回答一顆真正爲 Agent 而生的手機芯片,應該長什麼樣?
答案是有點難懂的 5GHz 的 Oryon CPU、FlexCache、Adreno Matrix Cores、18MB HPM、更大的 Hexagon 共享內存、以及未來更長期的近存計算探索。
也可以是很簡單的那句話:把飯桌搬到廚房那裏去。
劉學文
穩中向好。
郵箱新浪微博1
#歡迎關注愛範兒官方微信公衆號:愛範兒(微信號:ifanr),更多精彩內容第一時間爲您奉上。