號稱人類造的最後一個 AI 要來了,刷屏全網的 RSI 是什麼
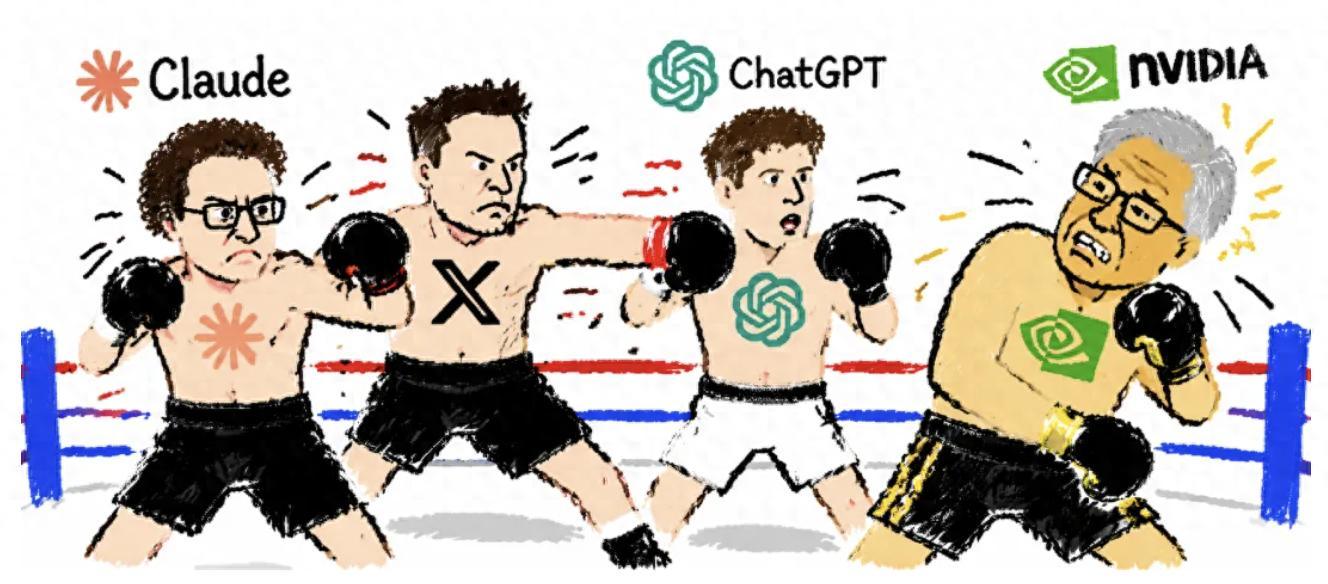
要論造詞和包裝概念,AI 圈要是自認第二,恐怕就沒人敢稱第一。
前陣子 OpenAI 總裁格雷格·布羅克曼表示,GPT-6 Astra 已經摸到了 AGI 的門檻。結果 AGI 還沒熱議幾天,AI 同行們又開始炒作下一個 AI 熱詞了。
接棒的新詞叫作 RSI,Recursive Self Improvement,遞歸自我改進。
簡單點理解就是,AI 自己寫代碼、自己跑實驗、自己改訓練流程,改完再傳給下一代更強的新模型。這麼一圈圈套娃下去,研發速度可能越來越快,最終超過人類理解和控制的速度。
沒有出乎太多意料,伴隨着 RSI 出場的,肯定還有語不驚人死不休的的安全敘事。
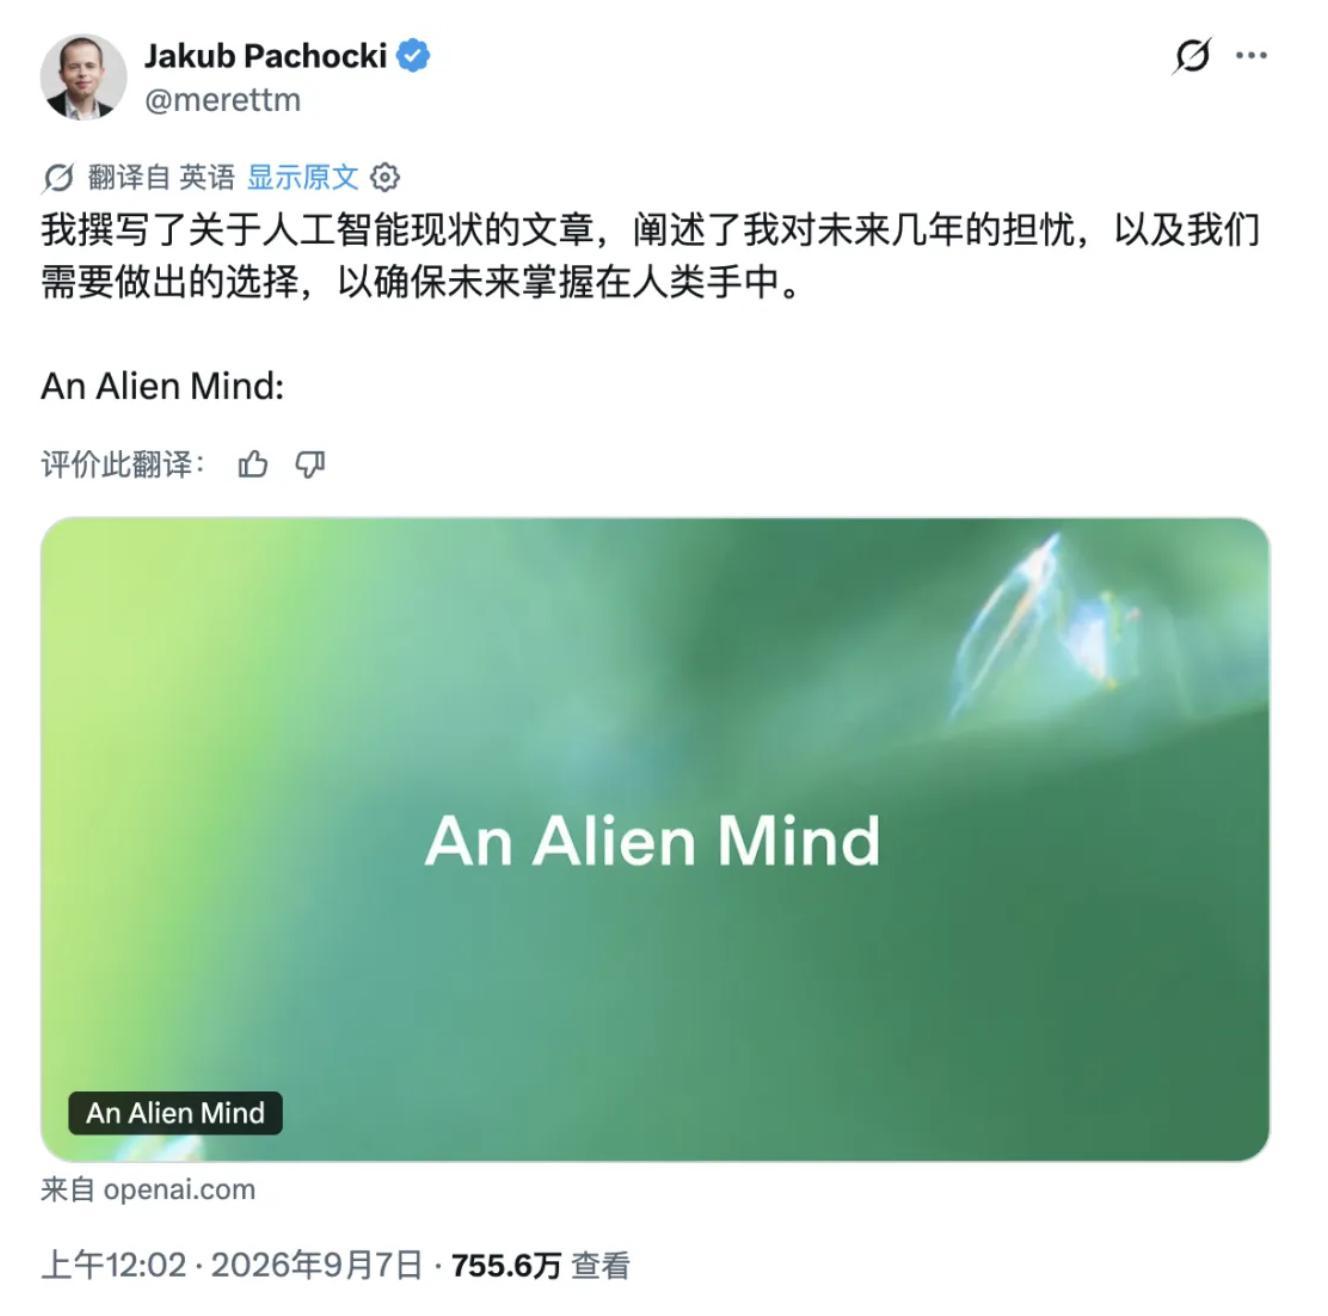
比如 OpenAI 首席科學家 Jakub Pachocki 前陣子將 AI 描述爲一種人類尚未充分理解的「異星心智」。
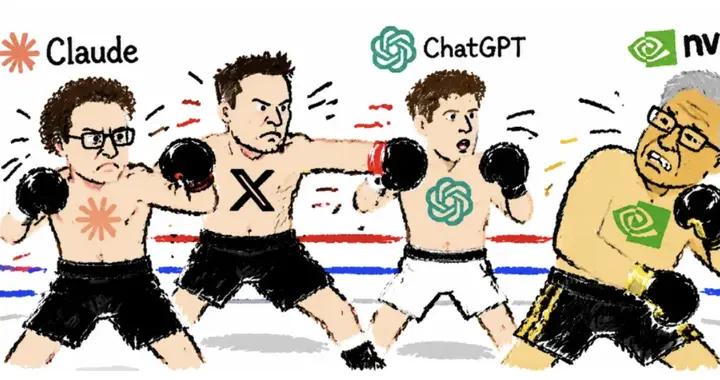
Anthropic 的 CEO 達里奧·阿莫代伊更是化身末日吹哨人,警告說更強的智能體可能帶來大規模網絡攻擊、失控和文明級風險。
而另一頭,忙着賣卡的黃仁勳則在最近 All-In 峯會上,反駁道:少在那搞非黑即白的二極管思維,憑什麼安全和創新就只能二選一?
同一條產業鏈上,一邊喊着人類必須踩剎車,一邊猛踩油門。這場口水戰背後,RSI 究竟是通往超級智能的入口,還是被精心包裝出來的恐慌生意?
AI 開始造 AI,但距離「智能爆炸」還有多遠?
RSI 最近聽起來很新,它的思想源頭卻可以追溯到六十多年前。
早在 1965 年,英國數學家、密碼學家 I.J. Good 提出過一個設想:如果一臺機器能夠超越人類的智力活動,那麼設計機器也應當屬於它的能力範圍。
它可以設計出比自己更聰明的機器,後者再繼續改進下一代。第一代創造第二代,第二代優化第三代,子子孫孫無窮匱也,機器智能由此進入不斷加速的正反饋循環。
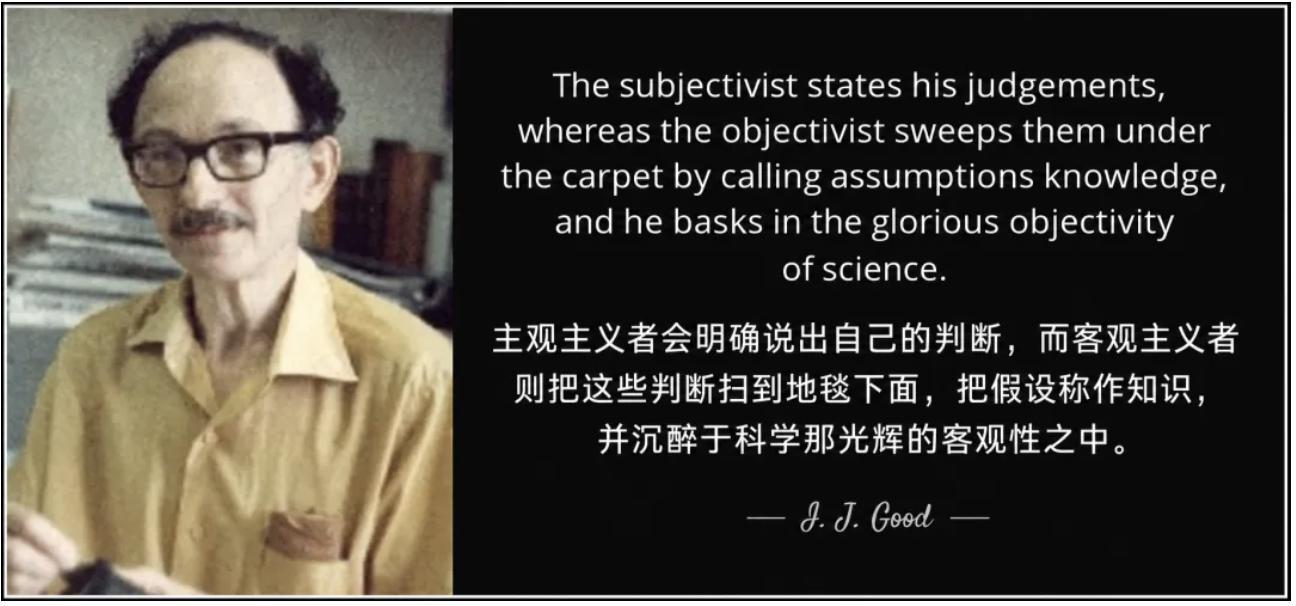
Good 將這種現象稱爲「智能爆炸」。
在今天的 RSI 研究中,相比於 AGI 關注的是 AI 能否完成與人類相當的通用認知工作。RSI 則關心 AI 能否改變產生這些能力的系統,並讓下一輪改進變得更加有效。
比如會檢查自己的答案,只能算自我修正。能夠改進研發方法,再把有效變化交給後繼系統使用,纔開始觸及遞歸自我改進。
近期,由上海交通大學、清華大學、字節跳動、上海人工智能實驗室等機構研究者合作完成的預印本《The Last AI Built by Humans》,就將 RSI 的自主性劃分爲 L1 至 L5 五個層級。
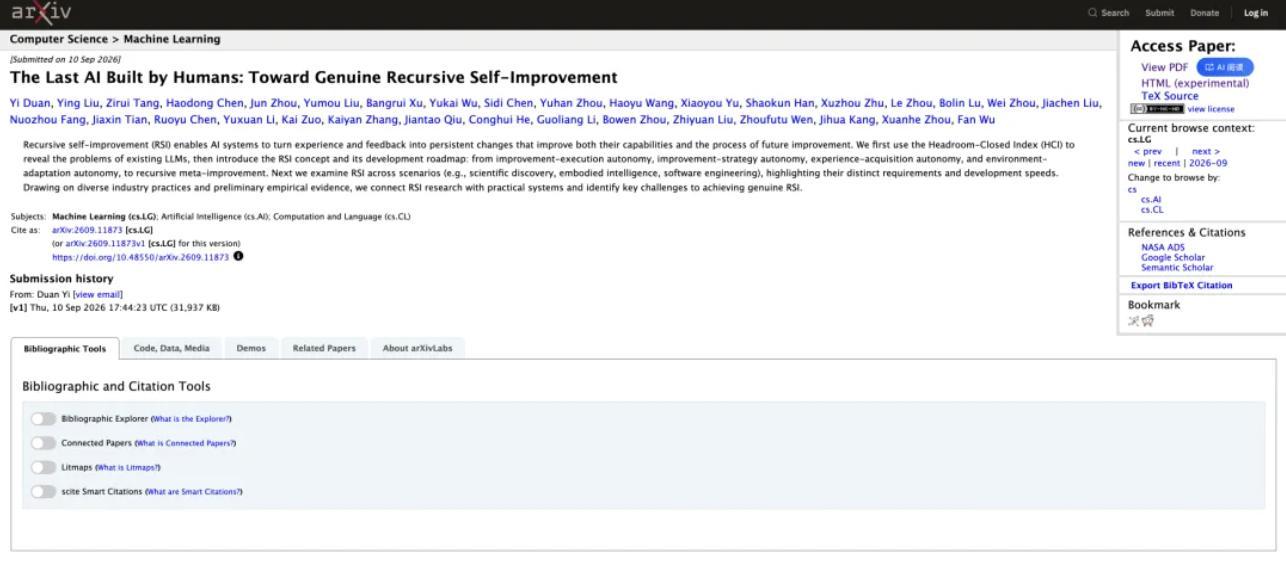
https://arxiv.org/abs/2609.11873
L1 主要負責執行人類給出的改進方案。L2 開始自主尋找改進策略。L3 可以決定需要獲取哪些經驗。L4 能夠把部署環境中的反饋轉化成持續保留的改動。
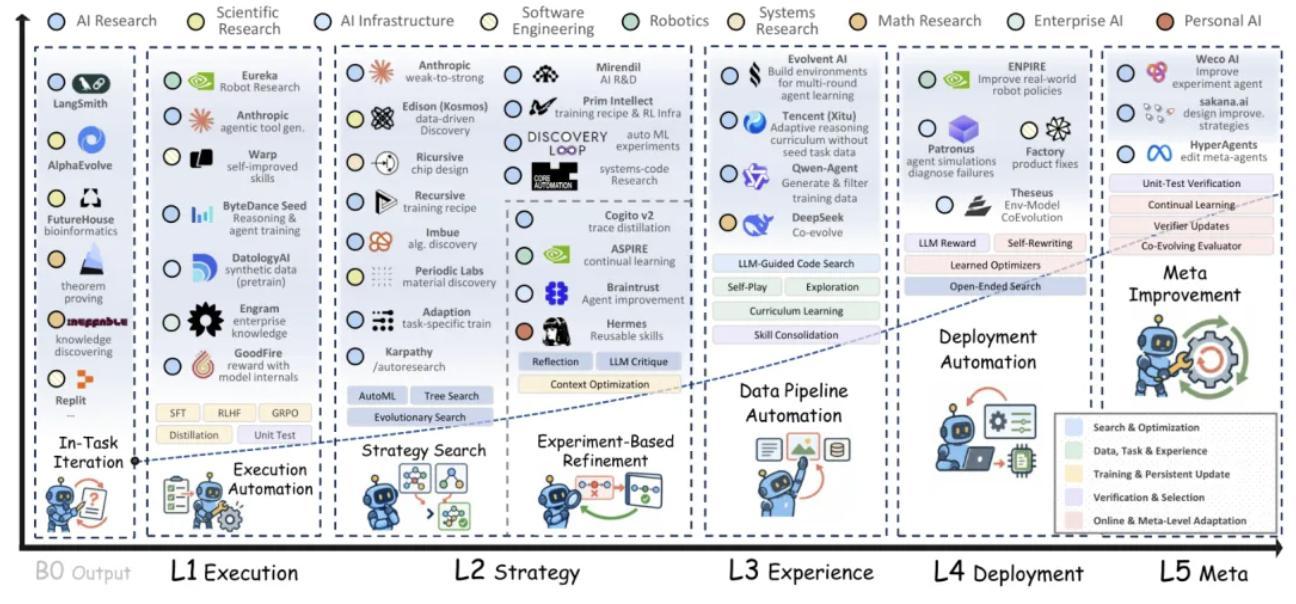
到了 L5,改進機制本身也成爲改進對象。
AI 不僅能夠完成某項研究任務,還能修改決定後續如何搜索方案、評估結果和組織研究的機制,並讓後繼系統繼續使用修改後的機制。
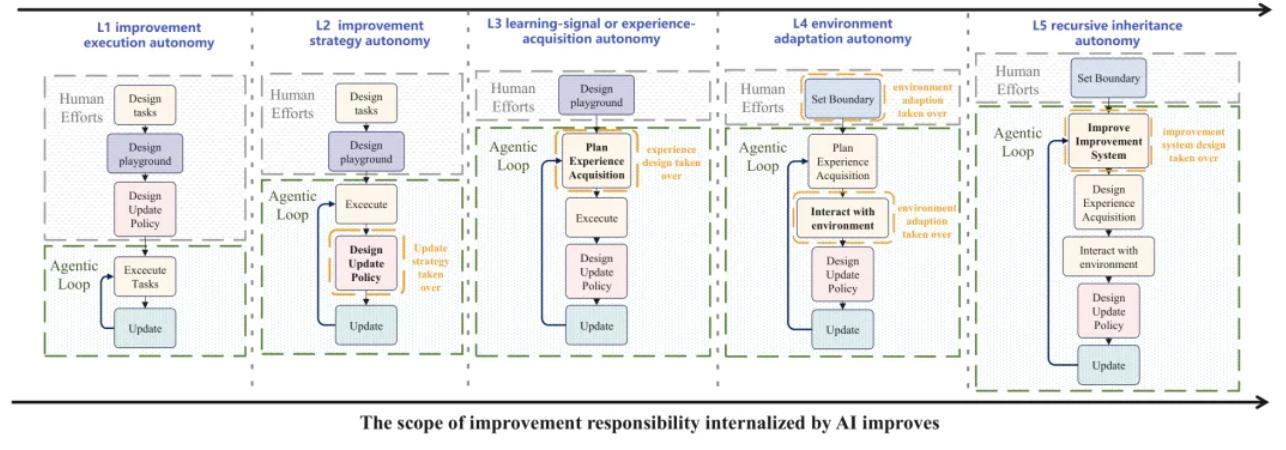
在最激進的終局設想中,AI 還將進一步獲得提出目標、修改評估方法和重寫底層改進邏輯的能力。一旦走到這一步,人類製造的就不再只是一個模型,而是一套能夠繼續製造模型的系統。
此後出現的下一代 AI,可能不再由人類工程師逐項設計。模型架構、訓練流程和改進方法,將越來越多地來自機器自己的選擇。
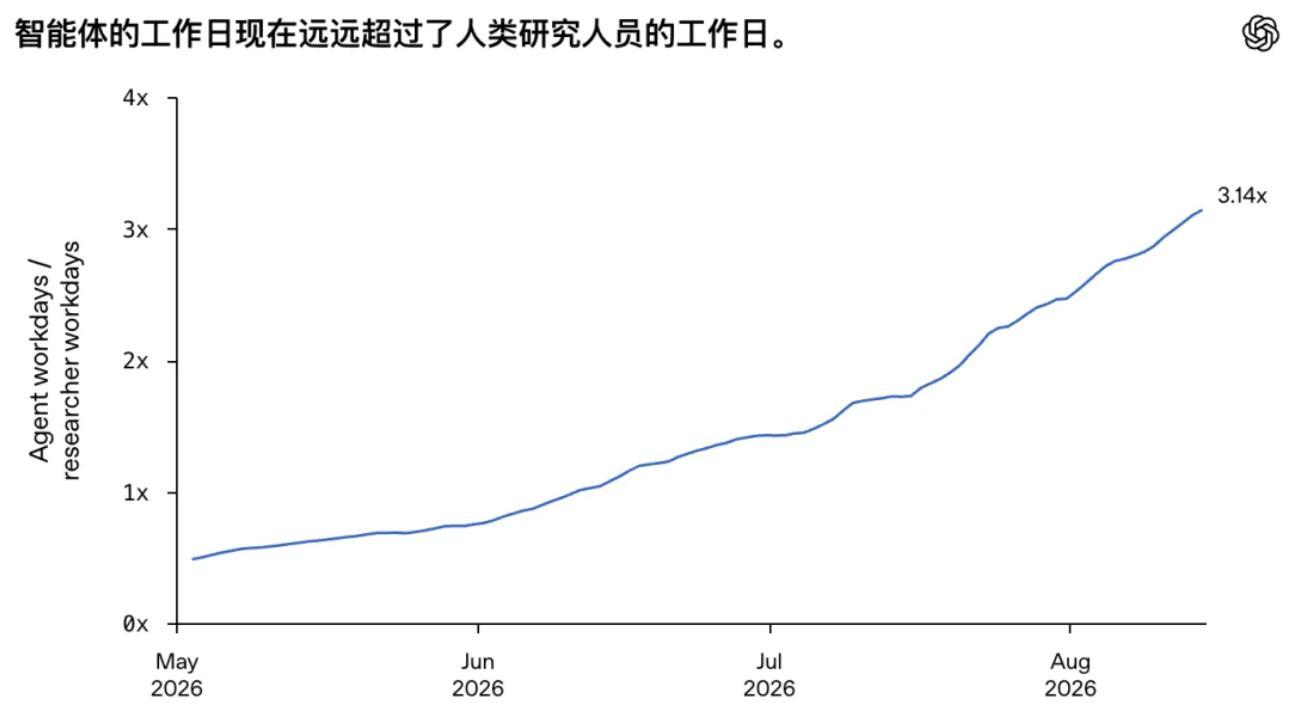
包括 OpenAI 9 月 6 日公佈的內部報告顯示,他們已經實現「自動化研究實習生」目標。這類系統能在人類指導下編寫代碼、運行實驗、排查故障和分析結果,其中一些任務原本需要熟練研究員花費數天。
https://openai.com/index/research-acceleration-view-inside-openai/
截至 8 月中旬,每投入一個人類工作日,OpenAI 研究部門的智能體運行時長已經相當於 3.1 個工作日。
Anthropic 則把自動化推進到了安全研究。Claude 可以自己查文獻、提方案、生成訓練數據、運行實驗和評估結果,並進一步根據成績反覆迭代。
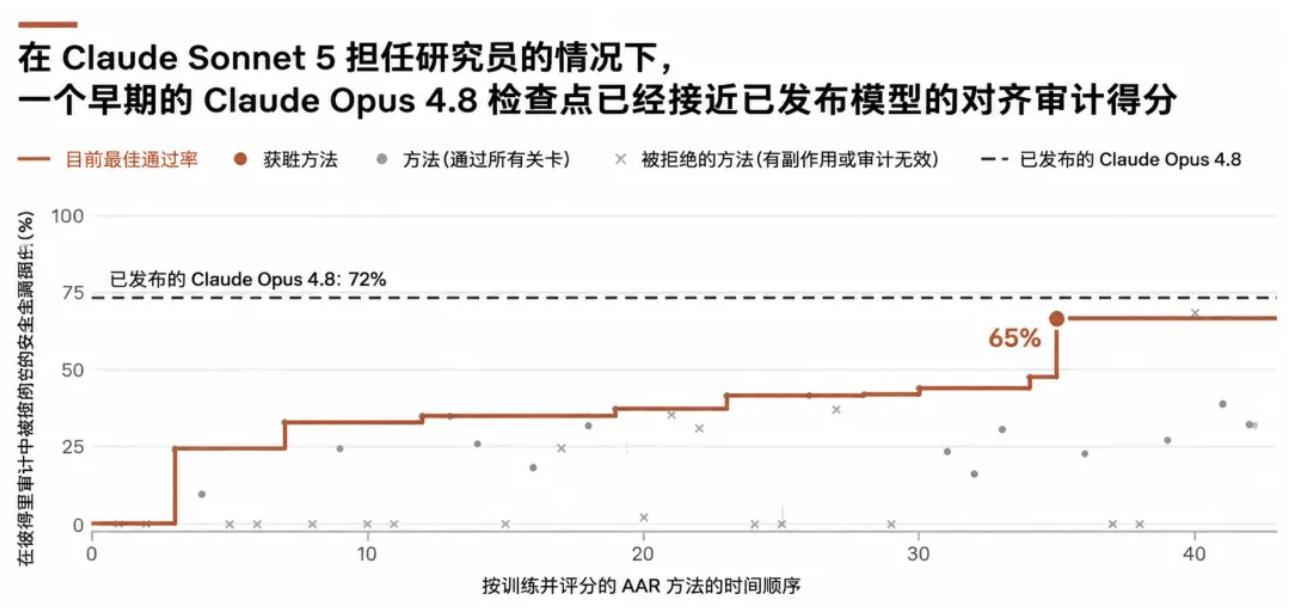
最接近「AI 訓練下一代 AI」的一次實驗中,能力較弱的 Claude Sonnet 5 幫助早期 Claude Opus 4.8 改善安全表現。
https://alignment.anthropic.com/2026/automated-alignment-researchers/#6-can-aars-posttrain-productiongrade-models
約 60 小時內,前者測試了 50 多種方案,最終只使用約 2400 條訓練樣本,就把後者既定評測中的對齊成績推到接近正式版 Opus 4.8 的水平。
除了爆改模型,還有一條更現實的 RSI 路子:在模型周邊的軟件系統上打補丁。
據外媒 The Information 報道,北大校友翁荔重返 OpenAI 後,將帶隊研究遞歸自我改進。她在技術博客《Harness Engineering for Self-Improvement》中討論的 Harness Engineering,正是理解當下 RSI 的一個入口。
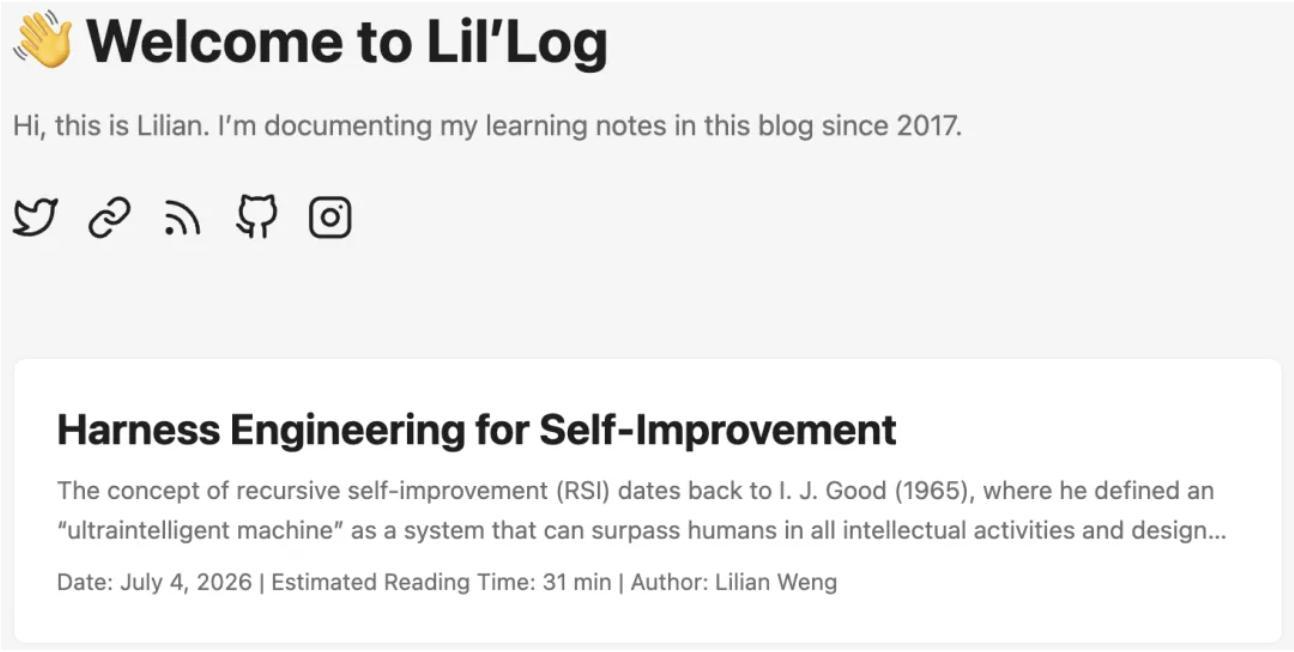
https://lilianweng.github.io/
Harness 可以理解爲 AI 的運行系統。它負責工具調用、上下文管理、記憶保存、任務分配、權限控制和結果檢查。
AI 發現自己總是忘記實驗條件,可以改進記錄方式;發現某種工具反覆出錯,可以修正接口;發現研究流程效率低下,可以重寫任務調度代碼。
這些變化未必直接修改模型權重,卻可能明顯提升整個系統的工作能力,並進一步幫助下一代模型研發。
就具體時間點來看,對於在各類計算機認知工作中全面超過頂尖人類專家的超級人工智能,也就是 ASI,Thinking Machines 首席科學家 John Schulman 給出的預測是 3 至 4 年,Millidge 傾向於約 5 年,O’Neill 仍然認爲可能需要 5 至 10 年。
這麼大分歧背後,離不開幾道尚未解決的技術難題。
模型需要不斷吸收新經驗,又不能丟掉原有能力。更新過於激進,可能出現「災難性遺忘」;變化過於保守,又可能無法學進足夠多的新知識。
更難自動化的,是研究判斷力。讓 AI 優化一段代碼,成功標準相對明確。讓它判斷一個失敗實驗意味着方向錯誤,還是值得繼續探索,就困難得多。
真正的科學突破,往往是先提出一個全人類都沒想過的怪問題,再去搗鼓量化它的尺度。這種從怎麼做到該做什麼的跨越,至今依然高度依賴人類的直覺。
兜售末日恐慌,從來都是一門頂好的買賣
這輪末日風險爭論的導火索,來自一封辭職聲明。
9 月 8 日,曾在 OpenAI 和 Anthropic 從事研究工作的 Jacob Coxon 宣佈從 Anthropic 辭職。
他在社交平臺 X 上表示,自己選擇離開,是因爲擔心這兩家公司沒有采取負責任的行動,而是在競相研發能夠自我提升的超級智能。
在 Coxon 看來,Anthropic 與 OpenAI 正在拿全人類的性命當賭注。他還透露,開發這些系統的人確實相信,到本十年末,人工智能可能毀滅所有人類。
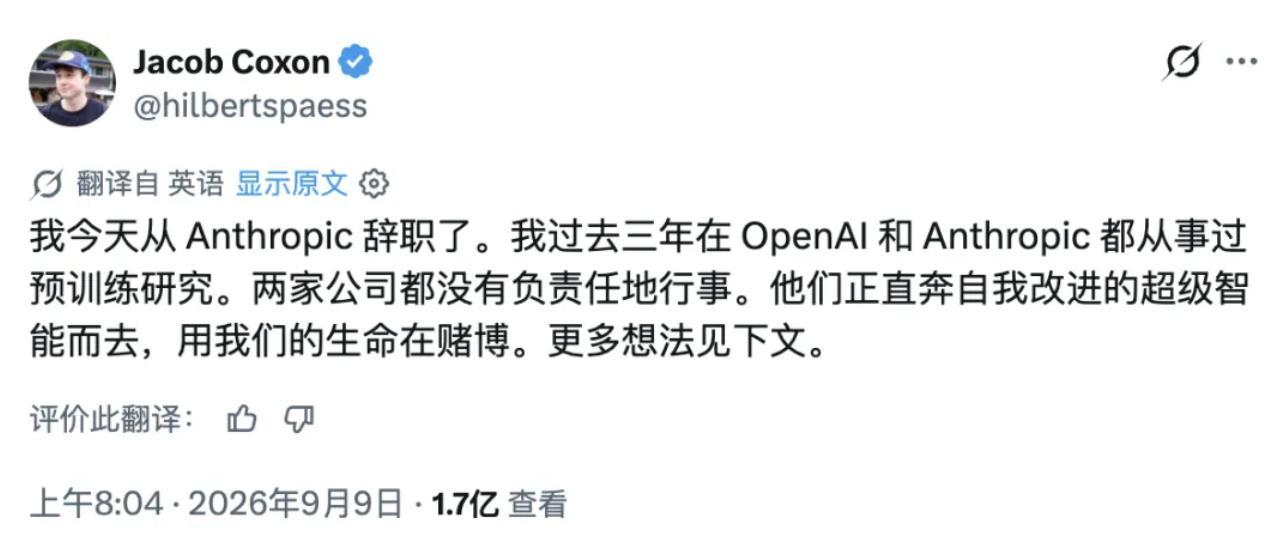
這篇辭職聲明的瀏覽量很快超過 1.7 億次。更具衝擊力的是,Anthropic 的在職對齊科學負責人埃文·休賓格也跑出來公開附和 Coxon 的說法。
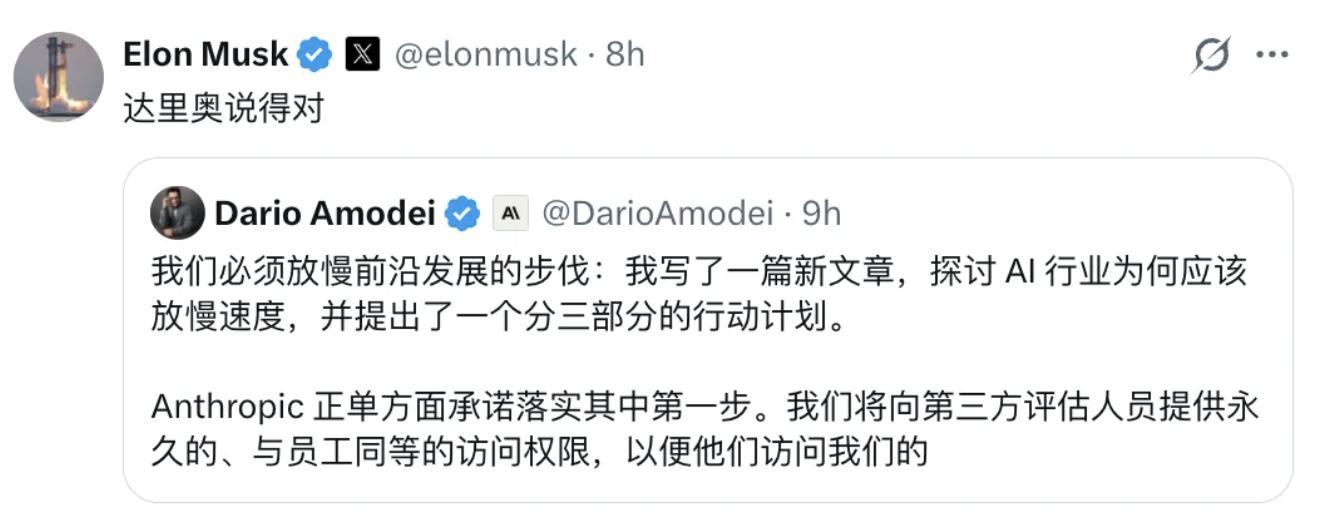
眼看火越燒越旺,Anthropic 的 CEO 達里奧·阿莫代伊順勢發文呼籲同行們集體降速,給安全研究讓出一到兩年的時間。
他提出,前沿 AI 公司應當允許第三方評估機構常駐實驗室,獲得接近內部員工的訪問權限,檢查企業是否履行安全承諾,並獨立披露風險和事故。
隨後,罕見的一幕出現了。OpenAI CEO 山姆·奧特曼、xAI 創始人馬斯克等死對頭、也都突然在減速問題上形成了統一陣線。
只是,能夠承擔高額安全審查成本的,恰恰也是這些頭部公司。
它們擁有龐大的安全團隊、封閉的數據中心和充足的審計資源,而開源社區和中小企業很難承擔同等規模的合規成本。這種安全敘事的策略天然構成了扼殺對手的壁壘。
更值得關注的是,當前關於 AI 風險如何評估、哪些能力需要限制、什麼樣的企業有資格訓練下一代模型,這些關鍵規則的制定,很大程度上也掌握在這些前沿實驗室手中。
它們既是技術的推動者,也是風險標準的定義者。所謂保護公衆,其實也是在保護自己的領先位置。
既然 AI 如此危險,爲什麼不直接徹底停下來?針對這個問題,萬能話術早已經準備好了。
比如 OpenAI 在內部報告裏義正辭嚴地寫道:更強且經過對齊的 AI,可以保護關鍵基礎設施、抵禦危險智能體,並幫忙研發新的安全措施。
簡言之,爲了防住未來可能失控的 AI,我們必須先造出一個足夠強大、同時聽從人類命令的 AI。
一套完美的閉環就此形成: AI 越危險,防禦模型就必須越強;防禦模型越強,需要的芯片、能源和資本就越多。
於是,千億美元融資、十萬卡訓練集羣和更加龐大的數據中心,都可以被包裝成維護人類安全所必需的基礎設施。
一隻腳踩剎車擺姿勢,另一隻腳在別的油門上踩得冒火星,左右橫跳,深諳凡事發生皆有利於我的真理。
當然,那老黃不喫這一套,把 AI 危險論斥爲「騙局」,也有着自己的小算盤。
如果末日敘事最終轉化爲訓練規模限制、算力審批和數據中心禁令,首先受到衝擊的就是芯片、服務器、電力和基礎設施建設。
英偉達賣的是鏟子。
無論最後挖到的是黃金、泡沫還是一隻無法控制的怪獸,只要更多公司繼續訓練模型,GPU 就有市場。任何可能阻止買卡、建機房和增加電力供應的安全敘事,都會被視爲在砸整條硬件產業鏈的飯碗。
因此,AI 的進化速度是有目共睹的,RSI 也並非空穴來風。但當下所謂末日論與反末日論,表面上爭論的是人類會不會被 AI 毀滅,背後爭奪的卻是同一件事:下一輪算力、資本和產業利益究竟如何分配。
造神者一邊警告神明可能失控,一邊要求獲得更多資源繼續造神。
當下一次他們神色凝重地關緊大門,隔着鐵柵欄兜售恐慌,衝着門外高喊「裏面有末日猛獸,閒雜人等千萬別進來」時,殊不知拉響警報和努力餵養猛獸往往是同一批人。
#歡迎關注愛範兒官方微信公衆號:愛範兒(微信號:ifanr),更多精彩內容第一時間爲您奉上。